
14redis主从集群结构
单点Redis的问题
单节点 Redis 在实际生产环境中面临多方面的问题:
- 并发能力问题:单节点 Redis 并发能力虽然不错,但也无法满足如 618 这样的高并发场景
- 故障恢复问题:如果 Redis 宕机,则服务不可用,需要一种自动的故障恢复手段
- 存储能力问题:Redis 基于内存,单节点能存储的数据量难以满足海量数据需求
- 数据丢失问题:Redis 是内存存储,服务重启可能会丢失数据
针对上述问题,Redis 提供了对应的解决方案:
| 问题 | 解决方案 |
|---|---|
| 并发能力问题 | 搭建主从集群,实现读写分离 |
| 故障恢复问题 | 利用 Redis 哨兵,实现健康检测和自动恢复 |
| 数据丢失问题 | 实现 Redis 数据持久化 |
| 存储能力问题 | 搭建分片集群,利用插槽机制实现动态扩容 |
Redis持久化
Redis 提供了两种持久化方式:RDB 和 AOF,对数据安全性要求较高时往往结合两者使用。
RDB持久化
RDB 全称 Redis Database Backup file(Redis 数据备份文件),也被叫做 Redis 数据快照,把内存中的所有数据都记录到磁盘中。当 Redis 实例故障重启后,从磁盘读取快照文件恢复数据。快照文件称为 RDB 文件,默认保存在当前运行目录,Redis 停机时会执行一次 RDB。
触发 RDB 的命令有两种:
save:由 Redis 主进程来执行 RDB,会阻塞所有命令bgsave:开启子进程执行 RDB,避免主进程受到影响
RDB 的其它配置可以在 redis.conf 文件中设置:
# 900秒内,如果至少有1个key被修改,则执行bgsave,如果是save "" 则表示禁用RDB
save 900 1
save 300 10
save 60 10000
# 是否压缩,建议不开启,压缩也会消耗cpu
rdbcompression yes
# RDB文件名称
dbfilename dump.rdb
# 文件保存的路径目录
dir ./
bgsave 开始时会 fork 主进程得到子进程,子进程共享主进程的内存数据,完成 fork 后读取内存数据并写入 RDB 文件。fork 采用的是 copy-on-write 技术:当主进程执行读操作时访问共享内存;当主进程执行写操作时则会拷贝一份数据执行写操作。
RDB 的缺点:执行间隔时间长,两次 RDB 之间写入数据有丢失的风险;fork 子进程、压缩、写出 RDB 文件都比较耗时。
AOF持久化
AOF 全称为 Append Only File(追加文件)。Redis 处理的每一个写命令都会记录在 AOF 文件,可以看做是命令日志文件。
AOF 默认是关闭的,需要修改 redis.conf 配置文件来开启:
# 是否开启AOF功能,默认是no
appendonly yes
# AOF文件的名称
appendfilename "appendonly.aof"
AOF 命令记录的频率可以通过 appendfsync 配置:
| 配置项 | 刷盘时机 | 优点 | 缺点 |
|---|---|---|---|
| always | 同步刷盘 | 可靠性高,几乎不丢数据 | 性能影响大 |
| everysec | 每秒刷盘 | 性能适中 | 最多丢失1秒数据 |
| no | 操作系统控制 | 性能最好 | 可靠性较差,可能丢失大量数据 |
因为 AOF 是记录命令,文件会比 RDB 文件大得多,而且会记录对同一个 key 的多次写操作,但只有最后一次才有意义。通过执行 bgrewriteaof 命令,可以让 AOF 文件执行重写功能,用最少的命令达到相同效果。Redis 也会在触发阈值时自动重写 AOF 文件。
RDB 与 AOF 对比:
| RDB | AOF | |
|---|---|---|
| 持久化方式 | 定时对整个内存做快照 | 记录每一次执行的命令 |
| 数据完整性 | 不完整,两次备份之间会丢失 | 相对完整,取决于刷盘策略 |
| 文件大小 | 会有压缩,文件体积小 | 记录命令,文件体积很大 |
| 宕机恢复速度 | 很快 | 慢 |
| 使用场景 | 可以容忍数分钟的数据丢失,追求更快的启动速度 | 对数据安全性要求较高 |
搭建主从集群
单节点 Redis 的并发能力是有上限的,要进一步提高 Redis 的并发能力,就需要搭建主从集群,实现读写分离。主节点 master 负责写操作,从节点 slave/replica 负责读操作,master 上的数据会同步到 slave。
假设有 A、B 两个 Redis 实例,要让 B 作为 A 的 slave 节点,只需在 B 节点执行命令:
slaveof A的IP A的port主从数据同步原理
全量同步
主从第一次同步是全量同步,流程分为三个阶段:
- 第一阶段:slave 执行
replicaof命令建立连接,请求同步数据;master 判断是否是第一次同步,是第一次则返回 master 的数据版本信息(replid 和 offset),slave 保存版本信息 - 第二阶段:master 执行
bgsave生成 RDB 并发送给 slave,同时将 RDB 期间的所有命令记录到 repl_baklog;slave 清空本地数据,加载 RDB 文件 - 第三阶段:master 将 repl_baklog 中的命令发送给 slave,slave 执行接收到的命令,保持与 master 同步
master 如何判断 slave 是不是第一次来同步数据?这里用到两个重要概念:
- Replication Id(replid):数据集的标记,id 一致则说明是同一数据集。每个 master 都有唯一的 replid,slave 会继承 master 节点的 replid
- offset:偏移量,随着记录在 repl_baklog 中的数据增多而逐渐增大。slave 完成同步时也会记录当前同步的 offset。如果 slave 的 offset 小于 master 的 offset,说明 slave 数据落后于 master,需要更新
slave 做数据同步,必须向 master 声明自己的 replication id 和 offset,master 才可以判断到底需要同步哪些数据。
增量同步
如果 slave 重启后再次同步,并且 repl_baklog 中能找到 offset,则执行增量同步:slave 提交自己的 offset 到 master,master 获取 repl_baklog 中从 offset 之后的命令给 slave。
需要注意的是,repl_baklog 大小有上限,写满后会覆盖最早的数据。如果 slave 断开时间过久,导致尚未备份的数据被覆盖,则无法基于 log 做增量同步,只能再次全量同步。
同步优化
可以从以下几个方面优化 Redis 主从集群:
- 在 master 中配置
repl-diskless-sync yes启用无磁盘复制,避免全量同步时的磁盘 IO - Redis 单节点上的内存占用不要太大,减少 RDB 导致的过多磁盘 IO
- 适当提高 repl_baklog 的大小,发现 slave 宕机时尽快实现故障恢复,尽可能避免全量同步
- 限制一个 master 上的 slave 节点数量,如果实在是太多 slave,则可以采用主-从-从链式结构,减少 master 压力
全量同步与增量同步的区别:
- 全量同步:master 将完整内存数据生成 RDB,发送 RDB 到 slave,后续命令则记录在 repl_baklog,逐个发送给 slave
- 增量同步:slave 提交自己的 offset 到 master,master 获取 repl_baklog 中从 offset 之后的命令给 slave
执行全量同步的时机:slave 节点第一次连接 master 节点时;slave 节点断开时间太久,repl_baklog 中的 offset 已经被覆盖时。执行增量同步的时机:slave 节点断开又恢复,并且在 repl_baklog 中能找到 offset 时。
Redis哨兵
slave 节点宕机恢复后可以找 master 节点同步数据,但 master 节点宕机则需要哨兵机制来实现自动故障恢复。
哨兵的作用
Redis 提供了哨兵(Sentinel)机制来实现主从集群的自动故障恢复:
- 监控:Sentinel 会不断检查 master 和 slave 是否按预期工作
- 自动故障恢复:如果 master 故障,Sentinel 会将一个 slave 提升为 master。当故障实例恢复后也以新的 master 为主
- 通知:Sentinel 充当 Redis 客户端的服务发现来源,当集群发生故障转移时,会将最新信息推送给 Redis 客户端
服务状态监控
Sentinel 基于心跳机制监测服务状态,每隔 1 秒向集群的每个实例发送 ping 命令:
- 主观下线:如果某 sentinel 节点发现某实例未在规定时间响应,则认为该实例主观下线
- 客观下线:若超过指定数量(quorum)的 sentinel 都认为该实例主观下线,则该实例客观下线。quorum 值最好超过 Sentinel 实例数量的一半
选举新的master
一旦发现 master 故障,sentinel 需要在 slave 中选择一个作为新的 master,选择依据是:
- 首先判断 slave 节点与 master 节点断开时间长短,如果超过指定值(
down-after-milliseconds * 10)则会排除该 slave 节点 - 然后判断 slave 节点的
slave-priority值,越小优先级越高,如果是 0 则永不参与选举 - 如果 slave-priority 一样,则判断 slave 节点的 offset 值,越大说明数据越新,优先级越高
- 最后判断 slave 节点的运行 id 大小,越小优先级越高
故障转移
当选中其中一个 slave 为新的 master 后,故障转移的步骤如下:
- sentinel 给备选的 slave 节点发送
slaveof no one命令,让该节点成为 master - sentinel 给所有其它 slave 发送
slaveof 新master的IP 端口命令,让这些 slave 成为新 master 的从节点,开始从新的 master 上同步数据 - sentinel 将故障节点标记为 slave,当故障节点恢复后会自动成为新 master 的 slave 节点
RedisTemplate的哨兵模式
在 Sentinel 集群监管下的 Redis 主从集群,其节点会因为自动故障转移而发生变化,Redis 客户端必须感知这种变化,及时更新连接信息。Spring 的 RedisTemplate 底层利用 lettuce 实现了节点的感知和自动切换。
引入 redis 的 starter 依赖后,在配置文件 application.yml 中指定 sentinel 相关信息:
spring:
  redis:
    sentinel:
      master: mymaster # 指定master名称
      nodes: # 指定redis-sentinel集群信息
        - 192.168.150.101:27001
        - 192.168.150.101:27002
        - 192.168.150.101:27003
配置主从读写分离:
@Bean
public LettuceClientConfigurationBuilderCustomizer configurationBuilderCustomizer(){
    return configBuilder -> configBuilder.readFrom(ReadFrom.REPLICA_PREFERRED);
}
ReadFrom 是配置 Redis 的读取策略,是一个枚举,包括:
MASTER:从主节点读取MASTER_PREFERRED:优先从 master 节点读取,master 不可用才读取 replicaREPLICA:从 slave(replica)节点读取REPLICA_PREFERRED:优先从 slave 节点读取,所有的 slave 都不可用才读取 master
Redis分片集群
主从和哨兵可以解决高可用、高并发读的问题,但依然有两个问题没有解决:海量数据存储问题和高并发写的问题。使用分片集群可以解决上述问题。
分片集群结构
分片集群的特征:
- 集群中有多个 master,每个 master 保存不同数据
- 每个 master 都可以有多个 slave 节点
- master 之间通过 ping 监测彼此健康状态
- 客户端请求可以访问集群任意节点,最终都会被转发到正确节点
散列插槽
Redis 会把每一个 master 节点映射到 0~16383 共 16384 个插槽(hash slot)上。数据 key 不是与节点绑定,而是与插槽绑定。Redis 会根据 key 的有效部分计算插槽值,分两种情况:
- key 中包含
{},且{}中至少包含 1 个字符,{}中的部分是有效部分 - key 中不包含
{},整个 key 都是有效部分
例如 key 是 num,就根据 num 计算;如果是 {itcast}num,则根据 itcast 计算。计算方式是利用 CRC16 算法得到一个 hash 值,然后对 16384 取余,得到的结果就是 slot 值。
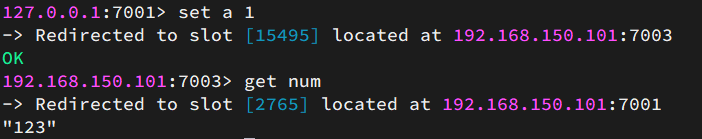
如果希望将同一类数据固定保存在同一个 Redis 实例,可以让这一类数据使用相同的有效部分,例如 key 都以 {typeId} 为前缀。
集群伸缩
redis-cli --cluster 提供了很多操作集群的命令,可以用来添加或删除节点。向集群添加新 master 节点后,需要为其分配插槽才能存储数据;删除节点前,需要先将其插槽迁移到其它节点。
故障转移
分片集群中当某个 master 宕机时,集群会自动进行故障转移:该实例与其它实例失去连接,疑似宕机,最终确定下线后自动提升一个 slave 为新的 master。
利用 cluster failover 命令可以手动让集群中的某个 master 宕机,切换到执行该命令的 slave 节点,实现无感知的数据迁移。流程如下:
- slave 节点告诉 master 节点拒绝任何客户端请求
- master 返回当前的数据 offset 给 slave
- 等待数据 offset 与 master 一致
- 开始故障转移
- 标记自己为 master,广播故障转移的结果
- 收到广播,开始处理客户端读请求
手动 Failover 支持三种模式:缺省(默认流程)、force(省略对 offset 的一致性校验)、takeover(直接执行第 5 步,忽略数据一致性、忽略 master 状态和其它 master 的意见)。
在项目中搭建主从集群
创建redis-slave和sentinel文件结构
我们在 /root/redis 中添加两个 slave 文件夹,三个 sentinel 文件夹。slave 中的 redis.conf 文件内容如下(slave1 中的 replica-announce-port 是 6380,slave2 中是 6381):
# 允许从库使用密码连接主库
masterauth 123456
requirepass 123456
replica-announce-ip 39.107.193.66
replica-announce-port 6380
sentinel.conf(sentinel monitor mymaster 的 IP 需要改成自己的 redis 主节点 IP 地址):
port 26379
dir /data
sentinel resolve-hostnames yes
sentinel monitor mymaster 0.0.0.1 6379 2
sentinel auth-pass mymaster 123456
sentinel down-after-milliseconds mymaster 5000
sentinel failover-timeout mymaster 10000
sentinel parallel-syncs mymaster 1
创建容器
启动两个从节点:
docker run -d \
  --name redis-slave1 \
  --network hm-net \
  -p 6380:6379 \
  -v /root/redis/slave1/conf/redis.conf:/etc/redis/redis.conf \
  -v /root/redis/slave1/data:/data \
  redis redis-server /etc/redis/redis.conf \
  --appendonly yes \
  --requirepass 123456 \
  --masterauth 123456 \
  --replica-announce-ip 39.107.193.66 \
  --replica-announce-port 6380
docker run -d \
--name redis-slave2 \
--network hm-net \
-p 6381:6379 \
-v /root/redis/slave2/conf/redis.conf:/etc/redis/redis.conf \
-v /root/redis/slave2/data:/data \
redis redis-server /etc/redis/redis.conf \
--appendonly yes \
--requirepass 123456 \
--masterauth 123456 \
--replica-announce-ip 39.107.193.66 \
--replica-announce-port 6381启动三个哨兵节点:
docker run -d \
  --name redis-sentinel1 \
  --network hm-net \
  --add-host=redis:$REDIS_IP \
  -p 26379:26379 \
  -v /root/redis/sentinel1/sentinel.conf:/etc/redis/sentinel.conf \
  -v /root/redis/sentinel1/data:/data \
  redis redis-sentinel /etc/redis/sentinel.conf
docker run -d \
--name redis-sentinel2 \
--network hm-net \
--add-host=redis:$REDIS_IP \
-p 26380:26379 \
-v /root/redis/sentinel2/sentinel.conf:/etc/redis/sentinel.conf \
-v /root/redis/sentinel2/data:/data \
redis redis-sentinel /etc/redis/sentinel.confdocker run -d \
--name redis-sentinel3 \
--network hm-net \
--add-host=redis:$REDIS_IP \
-p 26381:26379 \
-v /root/redis/sentinel3/sentinel.conf:/etc/redis/sentinel.conf \
-v /root/redis/sentinel3/data:/data \
redis redis-sentinel /etc/redis/sentinel.conf修改nacos配置文件
shared-redis.yaml 文件修改为:
spring:
  redis:
    password: 123456
    sentinel:
      master: mymaster
      nodes: 0.0.0.1:26379,0.0.0.1:26380,0.0.0.1:26381
    lettuce:
      pool:
        max-active: 8
        max-idle: 8
        min-idle: 0
        max-wait: 100ms
项目中配置读写分离
common 模块中 RedisConfig.java 文件中添加一个新的 Bean:
@Bean
public LettuceClientConfigurationBuilderCustomizer clientConfigurationBuilderCustomizer() {
  // 可选:ReadFrom.REPLICA_PREFERRED、MASTER、MASTER_PREFERRED、REPLICA
  return clientConfigurationBuilder -> clientConfigurationBuilder.readFrom(ReadFrom.REPLICA_PREFERRED);
}
这个 bean 中配置的就是读写策略,包括四种:
MASTER:从主节点读取MASTER_PREFERRED:优先从 master 节点读取,master 不可用才读取 replicaREPLICA:从 slave(replica)节点读取REPLICA_PREFERRED:优先从 slave(replica)节点读取,所有的 slave 都不可用才读取 master
项目下载地址
gupengzu/high-concurrency-project at 14redis-Master-Slave-Cluster