
15多级缓存
传统缓存的问题
传统的缓存策略一般是请求到达 Tomcat 后,先查询 Redis,如果未命中则查询数据库,存在下面的问题:
- 请求要经过 Tomcat 处理,Tomcat 的性能成为整个系统的瓶颈
- Redis 缓存失效时,会对数据库产生冲击
多级缓存方案
多级缓存就是充分利用请求处理的每个环节,分别添加缓存,减轻 Tomcat 压力,提升服务性能。整体的请求流转路径为:
- 浏览器访问静态资源时,优先读取浏览器本地缓存
- 访问非静态资源(ajax 查询数据)时,访问服务端
- 请求到达 Nginx 后,优先读取 Nginx 本地缓存
- 如果 Nginx 本地缓存未命中,则去直接查询 Redis(不经过 Tomcat)
- 如果 Redis 查询未命中,则查询 Tomcat
- 请求进入 Tomcat 后,优先查询 JVM 进程缓存
- 如果 JVM 进程缓存未命中,则查询数据库
用作缓存的 Nginx 是业务 Nginx,需要部署为集群,再有专门的 Nginx 用来做反向代理。由于请求是「前端 -> Nginx -> 后端 -> 数据库」,所以建立的多级缓存顺序为:Nginx 缓存 -> JVM 缓存 -> Redis 缓存 -> 数据库。
多级缓存能否提高效率
Nginx 缓存、JVM 缓存由于是在本地查询缓存,速度极快;Redis 缓存需要网络请求,但速度也比 MySQL 快一个数量级。最差的情况是所有缓存都没有需要的数据,所有缓存都读取一遍,然后读取完数据库还需要把所有缓存都更新一遍。但由于缓存读写速度极快,相对于直接读取数据库,性能几乎不会降低。而只要不是这种最坏情况,这个请求都可以省掉读取数据库的时间,所以建立多级缓存一定能提高性能。
多级缓存的顺序
JVM 缓存空间小但更快,Redis 缓存空间大但更慢。应该先查询更快的缓存,再查询更慢的缓存,所以查询顺序是:Nginx 缓存 -> JVM 缓存 -> Redis 缓存 -> 数据库。
JVM进程缓存
本地进程缓存
缓存在日常开发中起着至关重要的作用,由于存储在内存中,数据读取速度非常快,能大量减少对数据库的访问。缓存分为两类:
- 分布式缓存(如 Redis):优点是存储容量更大、可靠性更好、可以在集群间共享;缺点是访问缓存有网络开销。适合缓存数据量较大、可靠性要求较高、需要在集群间共享的场景
- 进程本地缓存(如 HashMap、GuavaCache):优点是读取本地内存没有网络开销,速度更快;缺点是存储容量有限、可靠性较低、无法共享。适合性能要求较高、缓存数据量较小的场景
初识Caffeine
Caffeine 是一个基于 Java8 开发的,提供了近乎最佳命中率的高性能的本地缓存库。目前 Spring 内部的缓存使用的就是 Caffeine。
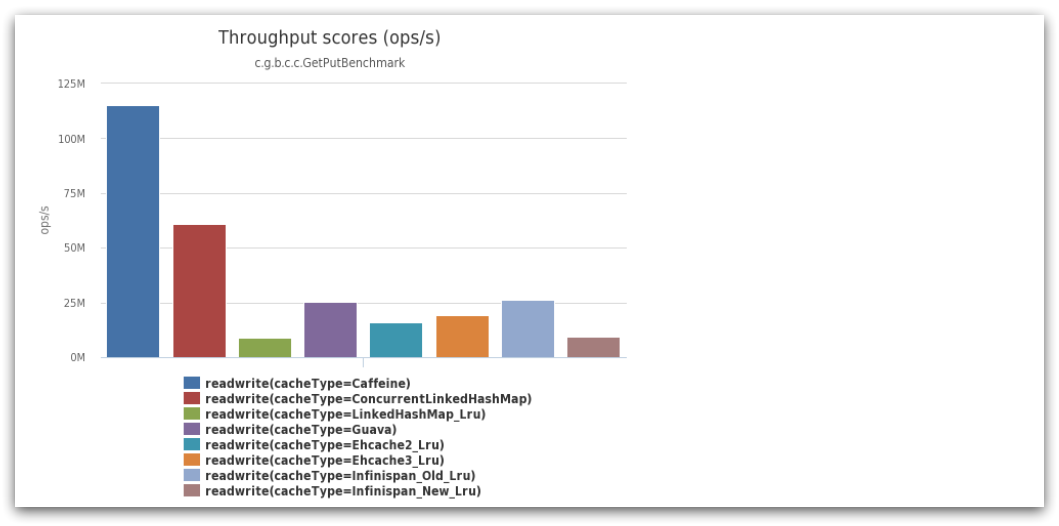
Caffeine 基本用法示例:
@Test
void testBasicOps() {
    // 创建缓存对象
    Cache<String, String> cache = Caffeine.newBuilder().build();

    // 存数据
    cache.put("gf", "迪丽热巴");

    // 取数据,不存在则返回null
    String gf = cache.getIfPresent("gf");
    System.out.println("gf = " + gf);

    // 取数据,参数一:缓存的key;参数二:Lambda表达式,参数是缓存的key,方法体是查询数据库的逻辑
    // 优先根据key查询JVM缓存,如果未命中,则执行参数二的Lambda表达式
    String defaultGF = cache.get("defaultGF", key -> {
        // 这里可以去数据库根据 key查询value
        return "柳岩";
    });
    System.out.println("defaultGF = " + defaultGF);
}
Caffeine 提供了三种缓存驱逐策略:
- 基于容量:设置缓存的数量上限
- 基于时间:设置缓存的有效时间
- 基于引用:设置缓存为软引用或弱引用,利用 GC 来回收缓存数据,性能较差,不建议使用
// 基于容量:设置缓存大小上限为1
Cache<String, String> cache = Caffeine.newBuilder()
        .maximumSize(1)
        .build();

// 基于时间:设置缓存有效期为10秒,从最后一次写入开始计时
Cache<String, String> cache = Caffeine.newBuilder()
        .expireAfterWrite(Duration.ofSeconds(10))
        .build();
在默认情况下,当一个缓存元素过期的时候,Caffeine 不会自动立即将其清理和驱逐,而是在一次读或写操作后,或者在空闲时间完成对失效数据的驱逐。
在项目中实现进程缓存
以 item-service 为例,首先添加 Caffeine 依赖:
<!--Caffeine缓存-->
<dependency>
    <groupId>com.github.ben-manes.caffeine</groupId>
    <artifactId>caffeine</artifactId>
</dependency>
然后创建 Caffeine 缓存配置类:
package com.hmall.item.config;

import com.github.benmanes.caffeine.cache.Cache;
import com.github.benmanes.caffeine.cache.Caffeine;
import com.hmall.item.domain.dto.ItemDTO;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import java.util.concurrent.TimeUnit;

@Configuration
public class CaffeineConfig {

  /**
   * 商品信息缓存
   * 缓存ItemDTO对象,用于快速查询商品信息
   */
  @Bean
  public Cache<Long, ItemDTO> itemCache() {
    return Caffeine.newBuilder()
        // 初始容量
        .initialCapacity(100)
        // 最大容量
        .maximumSize(10_000)
        // 写入后过期时间
        .expireAfterWrite(30, TimeUnit.MINUTES)
        // 访问后过期时间
        .expireAfterAccess(10, TimeUnit.MINUTES)
        // 启用统计
        .recordStats()
        .build();
  }
}
改造 ItemController 中的查询接口,原来只使用了 Redis 缓存,现在添加 JVM 缓存作为前置缓存:
@ApiOperation("根据id查询商品")
@GetMapping("{id}")
public ItemDTO queryItemById(@PathVariable("id") Long id) {
    String redisKey = "item:" + id;

    // 1. 先查JVM缓存(Caffeine)
    ItemDTO itemDTO = itemCache.getIfPresent(id);
    if (itemDTO != null) {
        return itemDTO;
    }

    // 2. 再查 Redis
    itemDTO = (ItemDTO) redisTemplate.opsForValue().get(redisKey);
    if (itemDTO != null) {
        // 回写到JVM缓存
        itemCache.put(id, itemDTO);
        return itemDTO;
    }

    // 3. 查数据库
    itemDTO = BeanUtils.copyBean(itemService.getById(id), ItemDTO.class);
    if (itemDTO != null) {
        // 4. 写入JVM缓存
        itemCache.put(id, itemDTO);
        // 5. 写入Redis,设置过期时间
        redisTemplate.opsForValue().set(redisKey, itemDTO, 1, java.util.concurrent.TimeUnit.HOURS);
    }
    return itemDTO;
}
需要注意的是,JVM 缓存是本地缓存,当在同一个 nacos 中开启多个相同的服务时,这些服务的 JVM 缓存是不共享的。建议使用 Nginx 来做请求路由(按 hash $request_uri 一致性哈希),使得相同的 url 请求只能发送到同一个 item-service 实例,从而让本地缓存命中率达到最高。
Lua语法入门
OpenResty 之所以能灵活创建缓存、读取缓存,是因为其允许用户使用 Lua 脚本语言来编写缓存逻辑。Lua 是一种轻量小巧的脚本语言,用标准 C 语言编写并以源代码形式开放,设计目的是为了嵌入应用程序中,从而为应用程序提供灵活的扩展和定制功能。
变量和循环
Lua 声明变量时不需要指定数据类型:
-- 声明字符串
local str = 'hello'
-- 字符串拼接可以使用 ..
local str2 = 'hello' .. 'world'
-- 声明数字
local num = 21
-- 声明布尔类型
local flag = true
-- 声明数组 key为索引的 table
local arr = {'java', 'python', 'lua'}
-- 声明table,类似java的map
local map =  {name='Jack', age=21}
-- 访问数组,lua数组的角标从1开始
print(arr[1])
-- 访问table
print(map['name'])
print(map.name)
数组、table 都可以利用 for 循环来遍历:
-- 遍历数组
for index,value in ipairs(arr) do
    print(index, value)
end
-- 遍历table
for key,value in pairs(map) do
   print(key, value)
end
条件控制、函数
定义函数的语法:
function 函数名(argument1, argument2..., argumentn)
    -- 函数体
    return 返回值
end
条件控制类似 Java 的 if、else 语法,与 java 不同的是布尔表达式中的逻辑运算是基于英文单词:
if(布尔表达式)
then
   -- 布尔表达式为 true 时执行该语句块
else
   -- 布尔表达式为 false 时执行该语句块
end| 操作符 | 描述 | 实例 |
|---|---|---|
| and | 逻辑与,若 A 为 false 则返回 A,否则返回 B | (A and B) 为 false |
| or | 逻辑或,若 A 为 true 则返回 A,否则返回 B | (A or B) 为 true |
| not | 逻辑非,与逻辑运算结果相反 | not(A and B) 为 true |
OpenResty快速入门
OpenResty® 是一个基于 Nginx 的高性能 Web 平台,用于方便地搭建能够处理超高并发、扩展性极高的动态 Web 应用、Web 服务和动态网关。具备下列特点:
- 具备 Nginx 的完整功能
- 基于 Lua 语言进行扩展,集成了大量精良的 Lua 库、第三方模块
- 允许使用 Lua 自定义业务逻辑、自定义库
修改nginx.conf
在 nginx.conf 的 http 下面,添加对 OpenResty 的 Lua 模块的加载,并在 server 下面添加对 /api/item 路径的监听:
# 加载lua模块
lua_package_path "/usr/local/openresty/lualib/?.lua;;";
# 加载c模块
lua_package_cpath "/usr/local/openresty/lualib/?.so;;";

location /api/item {
    # 响应类型,这里返回json
    default_type application/json;
    # 响应数据由 lua/item.lua这个文件来决定
    content_by_lua_file lua/item.lua;
}
在 nginx 目录创建 lua 文件夹,新建 item.lua 文件:
-- 返回假数据,这里的ngx.say()函数,就是写数据到Response中
ngx.say('{"id":10001,"name":"SALSA AIR"}')
重新加载配置 nginx -s reload 即可。
请求参数处理
OpenResty 提供了各种 API 用来获取不同类型的请求参数:
| 参数格式 | 参数示例 | 参数解析代码示例 |
|---|---|---|
| 路径占位符 | /item/1001 | local id = ngx.var[1](配合 location ~ /item/(\\d+) 正则匹配) |
| 请求头 | id:1001 | local headers = ngx.req.get_headers() |
| GET请求参数 | ?id=1001 | local getParams = ngx.req.get_uri_args() |
| POST表单参数 | id=1001 | ngx.req.read_body() 后 local postParams = ngx.req.get_post_args() |
| JSON参数 | {"id": 1001} | ngx.req.read_body() 后 local jsonBody = ngx.req.get_body_data() |
查询Tomcat
修改 item.lua,根据 id 向 Tomcat 服务发送请求查询商品信息。Nginx 提供了内部 API 用以发送 http 请求:
local resp = ngx.location.capture("/path",{
    method = ngx.HTTP_GET,   -- 请求方式
    args = {a=1,b=2},        -- get方式传参数
    body = "c=3&d=4"         -- post方式传参数
})返回的响应内容包括:resp.status(响应状态码)、resp.header(响应头,是一个 table)、resp.body(响应体)。这里的 path 是路径并不包含 IP 和端口,请求会被 nginx 内部的 server 监听并处理。要让请求发送到 Tomcat 服务器,还需要编写一个 server 对这个路径做反向代理:
location /path {
    # 这里是windows电脑的ip和Java服务端口,需要确保windows防火墙处于关闭状态
    proxy_pass http://192.168.150.1:8081;
}
封装http查询函数
把 http 查询请求封装为一个函数,放到 OpenResty 函数库中。在 /usr/local/openresty/lualib 目录下创建 common.lua:
-- 封装函数,发送http请求,并解析响应
local function read_http(path, params)
    local resp = ngx.location.capture(path,{
        method = ngx.HTTP_GET,
        args = params,
    })
    if not resp then
        -- 记录错误信息,返回404
        ngx.log(ngx.ERR, "http not found, path: ", path , ", args: ", args)
        ngx.exit(404)
    end
    return resp.body
end
-- 将方法导出
local _M = {
    read_http = read_http
}
return _M
在 item.lua 中使用该函数,并用 cjson 模块组装商品信息与库存信息:
-- 引入自定义工具模块
local common = require("common")
local read_http = common.read_http
-- 引入cjson
local cjson = require "cjson"

-- 获取路径参数
local id = ngx.var[1]

-- 根据id查询商品
local itemJSON = read_http("/item/".. id, nil)
-- 根据id查询商品库存
local itemStockJSON = read_http("/item/stock/".. id, nil)

-- 序列化为JSON格式并返回
local item = cjson.decode(itemJSON)
local stock = cjson.decode(itemStockJSON)
item.stock = stock.stock
ngx.say(cjson.encode(item))
Tomcat集群的负载均衡
当 Tomcat 部署为集群时,需要配置负载均衡。为了让同一个商品请求始终落到同一个 Tomcat 实例(便于本地缓存命中),采用基于请求 uri 的一致性哈希:
# tomcat集群配置
upstream tomcat-cluster{
    hash $request_uri;
    server 192.168.150.1:8081;
    server 192.168.150.1:8082;
}
# 反向代理配置,将/item路径的请求代理到tomcat集群
location /item {
    proxy_pass http://tomcat-cluster;
}
Redis缓存预热与查询
冷启动与缓存预热
- 冷启动:服务刚刚启动时,Redis 中并没有缓存,如果所有商品数据都在第一次查询时添加缓存,可能会给数据库带来较大压力
- 缓存预热:利用大数据统计用户访问的热点数据,在项目启动时将这些热点数据提前查询并保存到 Redis 中
在 item-service 中引入 Redis 依赖并配置地址后,编写初始化类,实现 InitializingBean 在 Bean 初始化时把数据写入 Redis:
@Component
public class RedisHandler implements InitializingBean {
    @Autowired
    private StringRedisTemplate redisTemplate;

    @Override
    public void afterPropertiesSet() throws Exception {
        // 初始化缓存:查询所有商品并写入Redis
    }
}
查询Redis缓存
OpenResty 提供了操作 Redis 的模块,引入后即可直接使用:
-- 引入redis模块
local redis = require("resty.redis")
-- 初始化Redis对象
local red = redis:new()
-- 设置Redis超时时间
red:set_timeouts(1000, 1000, 1000)

-- 关闭redis连接的工具方法,其实是放入连接池
local function close_redis(red)
    local pool_max_idle_time = 10000 -- 连接的空闲时间,单位是毫秒
    local pool_size = 100 --连接池大小
    local ok, err = red:set_keepalive(pool_max_idle_time, pool_size)
    if not ok then
        ngx.log(ngx.ERR, "放入Redis连接池失败: ", err)
    end
end

-- 查询redis的方法 ip和port是redis地址,key是查询的key
local function read_redis(ip, port, key)
    local ok, err = red:connect(ip, port)
    if not ok then
        ngx.log(ngx.ERR, "连接redis失败 : ", err)
        return nil
    end
    local resp, err = red:get(key)
    if not resp then
        ngx.log(ngx.ERR, "查询Redis失败: ", err, ", key = " , key)
    end
    if resp == ngx.null then
        resp = nil
        ngx.log(ngx.ERR, "查询Redis数据为空, key = ", key)
    end
    close_redis(red)
    return resp
end
在 item.lua 中封装 read_data 函数,实现先查询 Redis,未命中再查询 Tomcat:
-- 封装函数,先查询redis,再查询http
local function read_data(key, path, params)
    -- 查询redis
    local resp = read_redis("127.0.0.1", 6379, key)
    -- 判断redis是否命中
    if not resp then
        -- Redis查询失败,查询http
        resp = read_http(path, params)
    end
    return resp
end
Nginx本地缓存
OpenResty 为 Nginx 提供了 shared dict 的功能,可以在 Nginx 的多个 worker 之间共享数据,实现缓存功能。
开启共享字典,在 nginx.conf 的 http 下添加配置:
# 共享字典,也就是本地缓存,名称叫做:item_cache,大小150m
lua_shared_dict item_cache 150m;
操作共享字典:
-- 获取本地缓存对象
local item_cache = ngx.shared.item_cache
-- 存储, 指定key、value、过期时间,单位s,默认为0代表永不过期
item_cache:set('key', 'value', 1000)
-- 读取
local val = item_cache:get('key')
修改 item.lua 中的 read_data 函数,优先查询本地缓存,未命中时再查询 Redis、Tomcat,查询成功后将数据写入本地缓存并设置有效期(商品基本信息有效期 30 分钟,库存信息有效期 1 分钟):
-- 封装函数,先查询本地缓存,再查询redis,再查询http
local function read_data(key, expire, path, params)
    -- 读取本地缓存
    local val = item_cache:get(key)
    if not val then
        -- 缓存未命中,记录日志
        ngx.log(ngx.ERR, "本地缓存查询失败, key: ", key , ", 尝试redis查询")
        -- 查询redis
        val = read_redis("127.0.0.1", 6379, key)
        -- 判断redis是否命中
        if not val then
            ngx.log(ngx.ERR, "Redis缓存查询失败, key: ", key , ", 尝试http查询")
            -- Redis查询失败,查询http
            val = read_http(path, params)
        end
    end
    -- 写入本地缓存
    item_cache:set(key, val, expire)
    return val
end

-- 根据id查询商品
local itemJSON = read_data('item:id:' .. id, 1800, "/item/".. id, nil)
-- 根据id查询商品库存
local itemStockJSON = read_data('item:stock:id:' .. id, 60, "/item/stock/".. id, nil)
多级缓存总结
至此,多级缓存的完整查询链路已经建立:
- 浏览器客户端缓存:静态资源优先读取浏览器本地缓存
- Nginx 本地缓存:基于 OpenResty 的 shared dict,多个 worker 共享,未命中查询 Redis
- Redis 分布式缓存:未命中查询 Tomcat
- JVM 进程缓存:基于 Caffeine,进入 Tomcat 后优先查询本地进程缓存
- 数据库:最后兜底
整个链路逐层命中,最大程度降低数据库压力,应对亿级流量场景。