
02Java线程
本章是并发编程系列的第二篇,主线围绕 Java 线程展开:如何创建和运行线程、如何查看线程、线程底层是怎么运行的、Thread 的常用 API(start/run、sleep/yield、join、interrupt 等),以及从操作系统层面和 Java API 层面分别描述的线程状态。
创建和运行线程
方法一:直接使用 Thread
创建一个 Thread 的匿名子类对象,在 run() 方法里写要执行的任务,再调用 start() 启动:
// 创建线程对象
Thread t = new Thread() {
    public void run() {
        // 要执行的任务
    }
};
// 启动线程
t.start();
推荐通过构造参数给线程起一个有意义的名字,方便排查问题:
// 构造方法的参数是给线程指定名字,推荐
Thread t1 = new Thread("t1") {
    @Override
    // run 方法内实现了要执行的任务
    public void run() {
        log.debug("hello");
    }
};
t1.start();
输出:
19:19:00 [t1] c.ThreadStarter - hello方法二:使用 Runnable 配合 Thread
把【线程】和【任务】(要执行的代码)分开:
Thread代表线程;Runnable表示可运行的任务(线程要执行的代码)。
Runnable runnable = new Runnable() {
    public void run() {
        // 要执行的任务
    }
};
// 创建线程对象
Thread t = new Thread(runnable);
// 启动线程
t.start();
例如:
// 创建任务对象
Runnable task2 = new Runnable() {
    @Override
    public void run() {
        log.debug("hello");
    }
};

// 参数1 是任务对象; 参数2 是线程名字,推荐
Thread t2 = new Thread(task2, "t2");
t2.start();
输出:
19:19:00 [t2] c.ThreadStarter - helloJava 8 以后可以使用 lambda 精简代码:
// 创建任务对象
Runnable task2 = () -> log.debug("hello");

// 参数1 是任务对象; 参数2 是线程名字,推荐
Thread t2 = new Thread(task2, "t2");
t2.start();
原理之 Thread 与 Runnable 的关系:分析 Thread 的源码可以理清二者的关系——Thread 类本身也实现了 Runnable 接口,start() 启动线程后执行的 run() 方法,会先判断内部持有的 Runnable 任务对象是否为空,不为空就调用任务对象的 run()。
小结:
- 方法 1 是把线程和任务合并在了一起,方法 2 是把线程和任务分开了;
- 用
Runnable更容易与线程池等高级 API 配合; - 用
Runnable让任务类脱离了Thread继承体系,更灵活。
方法三:FutureTask 配合 Thread
FutureTask 能够接收 Callable 类型的参数,用来处理有返回结果的情况:
// 创建任务对象
FutureTask<Integer> task3 = new FutureTask<>(() -> {
    log.debug("hello");
    return 100;
});

// 参数1 是任务对象; 参数2 是线程名字,推荐
new Thread(task3, "t3").start();

// 主线程阻塞,同步等待 task 执行完毕的结果
Integer result = task3.get();
log.debug("结果是:{}", result);
输出:
19:22:27 [t3] c.ThreadStarter - hello
19:22:27 [main] c.ThreadStarter - 结果是:100
Runnable 的 run() 返回 void,无法带回结果;Callable 的 call() 允许返回一个结果,FutureTask 就是连接它与 Thread 的桥梁,调用它的 get() 方法可以(阻塞地)拿到任务的返回值。
观察多个线程同时运行
多个线程启动后,主要要理解两点:
- 线程之间是交替执行的;
- 谁先执行、谁后执行,由任务调度器决定,不由我们控制。
即使先 t1.start() 再 t2.start(),也不能保证 t1 的代码一定先于 t2 执行完毕。
查看进程线程的方法
Windows
- 任务管理器可以查看进程和线程数,也可以用来杀死进程;
tasklist查看进程;taskkill杀死进程。
Linux
ps -fe查看所有进程;ps -fT -p <PID>查看某个进程(PID)的所有线程;kill杀死进程;top按大写H切换是否显示线程;top -H -p <PID>查看某个进程(PID)的所有线程。
Java
jps命令查看所有 Java 进程;jstack <PID>查看某个 Java 进程(PID)的所有线程状态;jconsole来查看某个 Java 进程中线程的运行情况(图形界面)。
jconsole 远程监控配置
需要以如下方式运行你的 java 类:
java -Djava.rmi.server.hostname=`ip地址` -Dcom.sun.management.jmxremote \
-Dcom.sun.management.jmxremote.port=`连接端口` \
-Dcom.sun.management.jmxremote.ssl=是否安全连接 \
-Dcom.sun.management.jmxremote.authenticate=是否认证 java类
同时修改 /etc/hosts 文件将 127.0.0.1 映射至主机名。如果要认证访问,还需要做如下步骤:
- 复制
jmxremote.password文件; - 修改
jmxremote.password和jmxremote.access文件的权限为 600,即文件所有者可读写; - 连接时填入
controlRole(用户名)、R&D(密码)。
原理之线程运行
栈与栈帧
Java Virtual Machine Stacks(Java 虚拟机栈):我们都知道 JVM 运行时数据区由堆、栈、方法区等组成,其中栈内存就是给线程用的——每个线程启动后,虚拟机就会为其分配一块栈内存。
- 每个栈由多个**栈帧(Frame)**组成,栈帧对应着每次方法调用时所占用的内存;
- 每个线程只能有一个活动栈帧,对应着当前正在执行的那个方法。
方法调用时压入新栈帧(保存参数、局部变量、中间运算结果等),方法返回时栈帧弹出。因为每个线程都有自己独立的栈,所以线程之间的局部变量互不干扰。
线程上下文切换
因为以下一些原因,CPU 不再执行当前线程,转而执行另一个线程的代码:
- 线程的 CPU 时间片用完;
- 垃圾回收;
- 有更高优先级的线程需要运行;
- 线程自己调用了
sleep、yield、wait、join、park、synchronized、lock等方法。
当 Context Switch(上下文切换)发生时,需要由操作系统保存当前线程的状态,并恢复另一个线程的状态。Java 中对应的概念是程序计数器(Program Counter Register),它的作用是记住下一条 JVM 指令的执行地址,是线程私有的。
- 需要保存/恢复的状态包括程序计数器、虚拟机栈中每个栈帧的信息,如局部变量、操作数栈、返回地址等;
- Context Switch 频繁发生会影响性能。
常见方法
Thread 类的常用 API 整理如下:
| 方法名 | static | 功能说明 | 注意 |
|---|---|---|---|
start() |
启动一个新线程,在新的线程运行 run 方法中的代码 |
start 方法只是让线程进入就绪,里面代码不一定立刻运行(CPU 的时间片还没分给它)。每个线程对象的 start 方法只能调用一次,调用多次会出现 IllegalThreadStateException |
|
run() |
新线程启动后会调用的方法 | 如果构造 Thread 对象时传递了 Runnable 参数,则线程启动后会调用 Runnable 中的 run 方法,否则默认不执行任何操作。但可以创建 Thread 的子类对象来覆盖默认行为 | |
join() |
等待线程运行结束 | ||
join(long n) |
等待线程运行结束,最多等待 n 毫秒 | ||
getId() |
获取线程长整型的 id | id 唯一 | |
getName() |
获取线程名 | ||
setName(String) |
修改线程名 | ||
getPriority() |
获取线程优先级 | ||
setPriority(int) |
修改线程优先级 | Java 中规定线程优先级是 1~10 的整数,较大的优先级能提高该线程被 CPU 调度的机率 | |
getState() |
获取线程状态 | Java 中线程状态用 6 个枚举表示:NEW、RUNNABLE、BLOCKED、WAITING、TIMED_WAITING、TERMINATED | |
isInterrupted() |
判断是否被打断 | 不会清除打断标记 | |
isAlive() |
线程是否存活(还没有运行完毕) | ||
interrupt() |
打断线程 | 如果被打断线程正在 sleep、wait、join,会导致被打断的线程抛出 InterruptedException,并清除打断标记;如果打断的是正在运行的线程,则会设置打断标记;park 的线程被打断,也会设置打断标记 |
|
interrupted() |
static | 判断当前线程是否被打断 | 会清除打断标记 |
currentThread() |
static | 获取当前正在执行的线程 | |
sleep(long n) |
static | 让当前执行的线程休眠 n 毫秒,休眠时让出 CPU 的时间片给其它线程 | |
yield() |
static | 提示线程调度器让出当前线程对 CPU 的使用 | 主要是为了测试和调试 |
start 与 run
调用 run
public static void main(String[] args) {
    Thread t1 = new Thread("t1") {
        @Override
        public void run() {
            log.debug(Thread.currentThread().getName());
            FileReader.read(Constants.MP4_FULL_PATH);
        }
    };

    t1.run();
    log.debug("do other things ...");
}
输出:
19:39:14 [main] c.TestStart - main
19:39:14 [main] c.FileReader - read [1.mp4] start ...
19:39:18 [main] c.FileReader - read [1.mp4] end ... cost: 4227 ms
19:39:18 [main] c.TestStart - do other things ...
程序仍在 main 线程运行,FileReader.read() 方法调用还是同步的——读文件的 4 秒里主线程什么也干不了。
调用 start
将上述代码的 t1.run() 改为:
t1.start();输出:
19:41:30 [main] c.TestStart - do other things ...
19:41:30 [t1] c.TestStart - t1
19:41:30 [t1] c.FileReader - read [1.mp4] start ...
19:41:35 [t1] c.FileReader - read [1.mp4] end ... cost: 4542 ms
程序在 t1 线程运行,FileReader.read() 方法调用是异步的,主线程立刻就打印了 "do other things ..."。
小结:
- 直接调用
run()是在主线程中执行了run(),没有启动新的线程; - 使用
start()是启动新的线程,通过新的线程间接执行run()中的代码。
sleep 与 yield
sleep
- 调用
sleep会让当前线程从 Running 进入 Timed Waiting 状态(阻塞); - 其它线程可以使用
interrupt方法打断正在睡眠的线程,这时sleep方法会抛出InterruptedException; - 睡眠结束后的线程未必会立刻得到执行(只是回到就绪态,等待调度);
- 建议用
TimeUnit的 sleep 代替Thread的 sleep,来获得更好的可读性,例如TimeUnit.SECONDS.sleep(1)等价于Thread.sleep(1000)。
yield
- 调用
yield会让当前线程从 Running 进入 Runnable 就绪状态,然后调度执行其它线程; - 具体的实现依赖于操作系统的任务调度器——调度器完全可以忽略这个提示,马上又把时间片分回给它。
线程优先级
线程优先级会**提示(hint)**调度器优先调度该线程,但它仅仅是一个提示,调度器可以忽略它。如果 CPU 比较忙,优先级高的线程会获得更多的时间片;但 CPU 空闲时,优先级几乎没作用。
下面的例子可以用来体会 yield() 和优先级对调度的影响——两个死循环线程不断打印计数,取消注释后对比计数增长的差异:
Runnable task1 = () -> {
    int count = 0;
    for (;;) {
        System.out.println("---->1 " + count++);
    }
};
Runnable task2 = () -> {
    int count = 0;
    for (;;) {
        // Thread.yield();
        System.out.println("              ---->2 " + count++);
    }
};
Thread t1 = new Thread(task1, "t1");
Thread t2 = new Thread(task2, "t2");
// t1.setPriority(Thread.MIN_PRIORITY);
// t2.setPriority(Thread.MAX_PRIORITY);
t1.start();
t2.start();- 在 task2 中放开
Thread.yield(),会发现线程 1 的计数明显领先——线程 2 每次循环都主动让出 CPU; - 放开两行
setPriority,在 CPU 繁忙时也能观察到高优先级线程拿到更多执行机会。
join 方法详解
为什么需要 join
下面的代码执行后,打印的 r 是什么?
static int r = 0;

public static void main(String[] args) throws InterruptedException {
    test1();
}

private static void test1() throws InterruptedException {
    log.debug("开始");
    Thread t1 = new Thread(() -> {
        log.debug("开始");
        sleep(1);
        log.debug("结束");
        r = 10;
    });
    t1.start();
    log.debug("结果为:{}", r);
    log.debug("结束");
}
分析:因为主线程和线程 t1 是并行执行的,t1 线程需要 1 秒之后才能算出 r=10,而主线程一开始就要打印 r 的结果,所以只能打印出 r=0。
解决方法:
- 用
sleep行不行?为什么?——不可靠,你不知道 t1 具体要运行多久,睡少了结果还没算出,睡多了白等; - 用
join,加在t1.start()之后即可。t1.join()之后,时序变为:main 线程在 join 处等待,1 秒后 t1 终止,main 再继续,此时r=10。
同步与异步
以调用方角度来讲:
- 需要等待结果返回,才能继续运行就是同步;
- 不需要等待结果返回,就能继续运行就是异步。
等待多个结果
问:下面代码的 cost 大约是多少秒?
static int r1 = 0;
static int r2 = 0;

public static void main(String[] args) throws InterruptedException {
    test2();
}

private static void test2() throws InterruptedException {
    Thread t1 = new Thread(() -> {
        sleep(1);
        r1 = 10;
    });
    Thread t2 = new Thread(() -> {
        sleep(2);
        r2 = 20;
    });
    long start = System.currentTimeMillis();
    t1.start();
    t2.start();
    t1.join();
    t2.join();
    long end = System.currentTimeMillis();
    log.debug("r1: {} r2: {} cost: {}", r1, r2, end - start);
}
输出:
20:45:43.239 [main] c.TestJoin - r1: 10 r2: 20 cost: 2005分析如下:
- 第一个 join:等待 t1 时,t2 并没有停止,而在并行运行;
- 第二个 join:1 秒后执行到此处时,t2 也已经运行了 1 秒,因此只需再等待 1 秒。
所以总耗时是 2 秒而不是 3 秒。如果颠倒两个 join 的顺序(先 t2.join() 再 t1.join()),结论也一样:等完 t2 的 2 秒时 t1 早已结束,第二个 join 无需等待,最终输出相同。
有时效的 join
join(long n) 可以指定最多等待 n 毫秒,等够时间就继续:
static int r1 = 0;
static int r2 = 0;

public static void main(String[] args) throws InterruptedException {
    test3();
}

public static void test3() throws InterruptedException {
    Thread t1 = new Thread(() -> {
        sleep(1);
        r1 = 10;
    });

    long start = System.currentTimeMillis();
    t1.start();

    // 线程执行结束会导致 join 结束
    t1.join(1500);
    long end = System.currentTimeMillis();
    log.debug("r1: {} r2: {} cost: {}", r1, r2, end - start);
}
t1 实际 1 秒就结束了,join 会随之提前结束,输出:
20:48:01.320 [main] c.TestJoin - r1: 10 r2: 0 cost: 1010如果没等够时间——t1 需要睡眠 2 秒,而 join 只等 1500 毫秒:
public static void test3() throws InterruptedException {
    Thread t1 = new Thread(() -> {
        sleep(2);
        r1 = 10;
    });

    long start = System.currentTimeMillis();
    t1.start();

    // 线程执行结束会导致 join 结束
    t1.join(1500);
    long end = System.currentTimeMillis();
    log.debug("r1: {} r2: {} cost: {}", r1, r2, end - start);
}
输出:
20:52:15.623 [main] c.TestJoin - r1: 0 r2: 0 cost: 1502超时后主线程不再等待,r1 还没来得及被赋值。
interrupt 方法详解
打断 sleep、wait、join 的线程
这几个方法都会让线程进入阻塞状态。打断 sleep 的线程,会清空打断状态(打断标记仍为 false),并抛出异常。以 sleep 为例:
private static void test1() throws InterruptedException {
    Thread t1 = new Thread(() -> {
        sleep(1);
    }, "t1");
    t1.start();

    sleep(0.5);
    t1.interrupt();
    log.debug(" 打断状态: {}", t1.isInterrupted());
}
输出:
java.lang.InterruptedException: sleep interrupted
    at java.lang.Thread.sleep(Native Method)
    at java.lang.Thread.sleep(Thread.java:340)
    at java.util.concurrent.TimeUnit.sleep(TimeUnit.java:386)
    at cn.itcast.n2.util.Sleeper.sleep(Sleeper.java:8)
    at cn.itcast.n4.TestInterrupt.lambda$test1$3(TestInterrupt.java:59)
    at java.lang.Thread.run(Thread.java:745)
21:18:10.374 [main] c.TestInterrupt -  打断状态: false
打断正常运行的线程
打断正常运行的线程,不会清空打断状态,但仅仅是设置一个打断标记,线程本身不会停下来,需要线程自己去检测标记并决定如何退出:
private static void test2() throws InterruptedException {
    Thread t2 = new Thread(() -> {
        while (true) {
            Thread current = Thread.currentThread();
            boolean interrupted = current.isInterrupted();
            if (interrupted) {
                log.debug(" 打断状态: {}", interrupted);
                break;
            }
        }
    }, "t2");
    t2.start();

    sleep(0.5);
    t2.interrupt();
}
输出:
20:57:37.964 [t2] c.TestInterrupt - 打断状态: true这是一种优雅停止线程的思路:被停止的线程自己检测打断标记,在合适的时机把后事料理完再退出,而不是被强行杀死。
打断 park 线程
打断 LockSupport.park() 挂起的线程,不会清空打断状态:
private static void test3() throws InterruptedException {
    Thread t1 = new Thread(() -> {
        log.debug("park...");
        LockSupport.park();
        log.debug("unpark...");
        log.debug("打断状态:{}", Thread.currentThread().isInterrupted());
    }, "t1");
    t1.start();

    sleep(0.5);
    t1.interrupt();
}
输出:
21:11:52.795 [t1] c.TestInterrupt - park...
21:11:53.295 [t1] c.TestInterrupt - unpark...
21:11:53.295 [t1] c.TestInterrupt - 打断状态:true
打断标记已经是 true 时,park 会失效
private static void test4() {
    Thread t1 = new Thread(() -> {
        for (int i = 0; i < 5; i++) {
            log.debug("park...");
            LockSupport.park();
            log.debug("打断状态:{}", Thread.currentThread().isInterrupted());
        }
    });
    t1.start();

    sleep(1);
    t1.interrupt();
}
输出:
21:13:48.783 [Thread-0] c.TestInterrupt - park...
21:13:49.809 [Thread-0] c.TestInterrupt - 打断状态:true
21:13:49.812 [Thread-0] c.TestInterrupt - park...
21:13:49.813 [Thread-0] c.TestInterrupt - 打断状态:true
21:13:49.813 [Thread-0] c.TestInterrupt - park...
21:13:49.813 [Thread-0] c.TestInterrupt - 打断状态:true
21:13:49.813 [Thread-0] c.TestInterrupt - park...
21:13:49.813 [Thread-0] c.TestInterrupt - 打断状态:true
21:13:49.813 [Thread-0] c.TestInterrupt - park...
21:13:49.813 [Thread-0] c.TestInterrupt - 打断状态:true
第一次 park 被 interrupt 唤醒后,打断标记一直是 true,后续的 park 全部直接放行,循环瞬间转完。
提示:可以使用静态方法
Thread.interrupted()清除打断状态(它在返回标记的同时会重置标记),park 就能重新生效。
不推荐的方法
还有一些不推荐使用的方法,这些方法已过时,它们容易破坏同步代码块,造成线程死锁:
| 方法名 | 功能说明 |
|---|---|
stop() |
停止线程运行 |
suspend() |
挂起(暂停)线程运行 |
resume() |
恢复线程运行 |
stop() 会强行终止线程,线程持有的锁会被立刻释放,但它正在修改的数据可能只改了一半,其他线程拿到的就是不一致的中间状态;suspend() 挂起线程时不会释放锁,如果恢复它的线程正需要这把锁,就会死锁。优雅终止应当优先使用 interrupt 两阶段终止的思路。
主线程与守护线程
默认情况下,Java 进程需要等待所有线程都运行结束才会结束。有一种特殊的线程叫做守护线程(Daemon Thread):只要其它非守护线程运行结束了,即使守护线程的代码没有执行完,也会被强制结束。
log.debug("开始运行...");
Thread t1 = new Thread(() -> {
    log.debug("开始运行...");
    sleep(2);
    log.debug("运行结束...");
}, "daemon");
// 设置该线程为守护线程
t1.setDaemon(true);
t1.start();

sleep(1);
log.debug("运行结束...");
输出:
08:26:38.123 [main] c.TestDaemon - 开始运行...
08:26:38.213 [daemon] c.TestDaemon - 开始运行...
08:26:39.215 [main] c.TestDaemon - 运行结束...
主线程(非守护线程)1 秒后结束,守护线程本来还要 sleep 2 秒,但没有等到 "运行结束..." 打印,进程就退出了。
注意:
- 垃圾回收器线程就是一种守护线程;
- Tomcat 中的 Acceptor 和 Poller 线程都是守护线程,所以 Tomcat 接收到 shutdown 命令后,不会等待它们处理完当前请求。
五种状态
这是从操作系统层面来描述的:
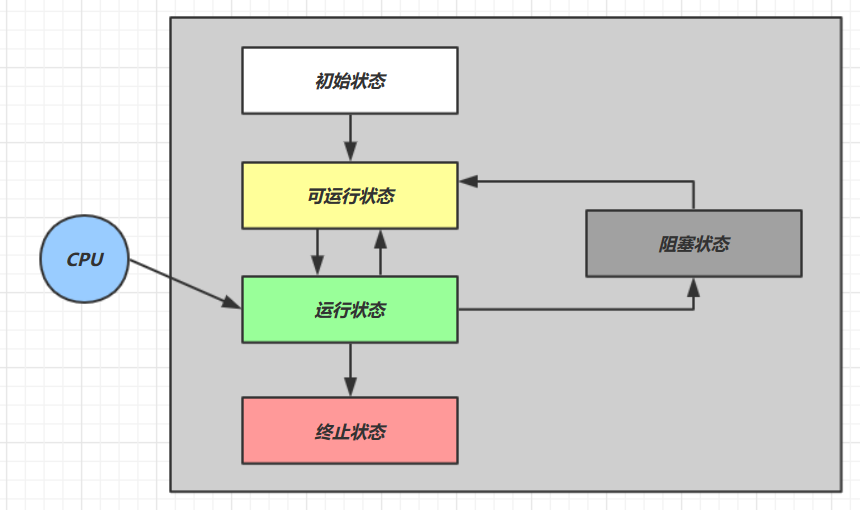
- 【初始状态】:仅是在语言层面创建了线程对象,还未与操作系统线程关联;
- 【可运行状态】(就绪状态):指该线程已经被创建(与操作系统线程关联),可以由 CPU 调度执行;
- 【运行状态】:指获取了 CPU 时间片运行中的状态。当 CPU 时间片用完,会从【运行状态】转换至【可运行状态】,会导致线程的上下文切换;
- 【阻塞状态】:
- 如果调用了阻塞 API,如 BIO 读写文件,这时该线程实际不会用到 CPU,会导致线程上下文切换,进入【阻塞状态】;
- 等 BIO 操作完毕,会由操作系统唤醒阻塞的线程,转换至【可运行状态】;
- 与【可运行状态】的区别是:对【阻塞状态】的线程来说,只要它们一直不唤醒,调度器就一直不会考虑调度它们;
- 【终止状态】:表示线程已经执行完毕,生命周期已经结束,不会再转换为其它状态。
六种状态
这是从 Java API 层面来描述的。根据 Thread.State 枚举,线程分为六种状态:
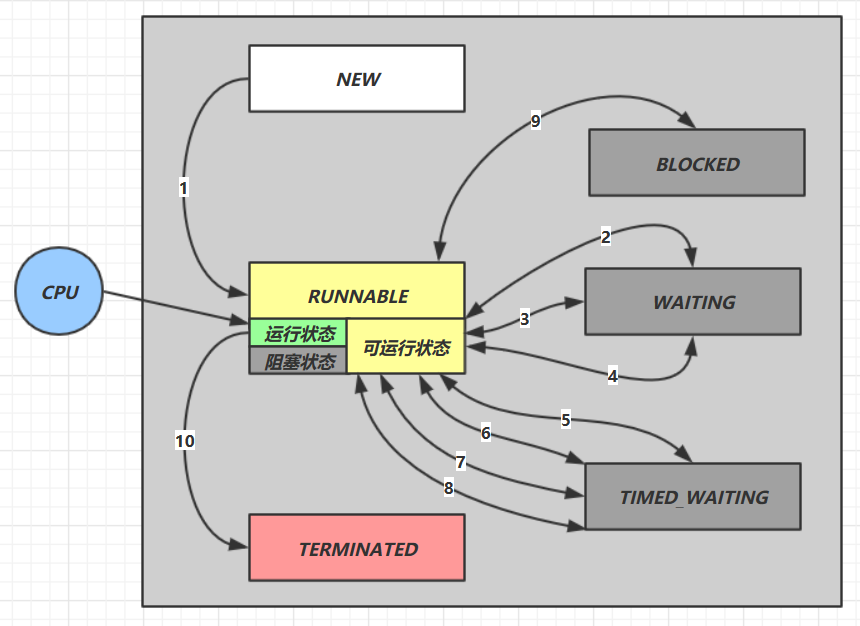
- NEW:线程刚被创建,但是还没有调用
start()方法; - RUNNABLE:当调用了
start()方法之后。注意,Java API 层面的 RUNNABLE 状态涵盖了操作系统层面的【可运行状态】、【运行状态】和【阻塞状态】(由于 BIO 导致的线程阻塞在 Java 里无法区分,仍然认为是可运行); - BLOCKED、WAITING、TIMED_WAITING:都是 Java API 层面对【阻塞状态】的细分,例如等待 synchronized 锁对应 BLOCKED,无限期等待(
wait()、join())对应 WAITING,带超时的等待(sleep(n)、wait(n)、join(n))对应 TIMED_WAITING; - TERMINATED:当线程代码运行结束。
习题:烧水泡茶
阅读华罗庚《统筹方法》,给出烧水泡茶的多线程解决方案。题目提示:
- 参考图二,用两个线程(两个人协作)模拟烧水泡茶过程;
- 文中办法乙、丙都相当于任务串行,而图一相当于启动了 4 个线程,有点浪费;
- 用
sleep(n)模拟洗茶壶、洗水壶等耗费的时间。
工序与耗时:
| 工序 | 耗时 |
|---|---|
| 洗水壶 | 1 分钟 |
| 烧开水 | 15 分钟 |
| 洗茶壶 | 1 分钟 |
| 洗茶杯 | 2 分钟 |
| 拿茶叶 | 1 分钟 |
| 泡茶 | —— |
想泡壶茶喝,当时的情况是:开水没有;水壶要洗,茶壶、茶杯要洗;火已生了,茶叶也有了。怎么办?
- 办法甲:洗好水壶,灌上凉水,放在火上;在等待水开的时间里,洗茶壶、洗茶杯、拿茶叶;等水开了,泡茶喝。
- 办法乙:先做好一些准备工作,洗水壶、洗茶壶茶杯、拿茶叶;一切就绪,灌水烧水;坐待水开了,泡茶喝。
- 办法丙:洗净水壶,灌上凉水,放在火上,坐待水开;水开了之后,急急忙忙找茶叶、洗茶壶茶杯,泡茶喝。
哪一种办法省时间?一眼就能看出第一种办法好,后两种都窝了工:洗水壶是烧开水的前提,没开水、没茶叶、不洗茶壶茶杯就不能泡茶。办法甲总共要 16 分钟(洗水壶 1 分钟 + 烧开水 15 分钟,洗茶壶茶杯、拿茶叶共 4 分钟在等水开时并行完成),而办法乙、丙需要 20 分钟。要缩短工时、提高效率,应当主要抓“烧开水”这个耗时最长的关键环节,把不依赖它的准备工作利用等待时间并行做掉。
参考实现: 让“老王”线程负责洗水壶、烧开水,“小王”线程负责洗茶壶、洗茶杯、拿茶叶;小王准备完后等待老王的水烧开,最后两人汇合泡茶。用秒数模拟分钟:
@Slf4j
public class TestTeaMaker {

    static void sleep(int second) {
        try {
            TimeUnit.SECONDS.sleep(second);
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }
    }

    public static void main(String[] args) {
        // 老王:洗水壶(1分钟)-> 烧开水(15分钟),关键路径
        Thread laoWang = new Thread(() -> {
            log.debug("洗水壶");
            sleep(1);
            log.debug("烧开水");
            sleep(15);
        }, "老王");

        // 小王:洗茶壶(1分钟)-> 洗茶杯(2分钟)-> 拿茶叶(1分钟),共 4 分钟
        Thread xiaoWang = new Thread(() -> {
            log.debug("洗茶壶");
            sleep(1);
            log.debug("洗茶杯");
            sleep(2);
            log.debug("拿茶叶");
            sleep(1);
            try {
                // 自己的活 4 分钟就干完了,等老王把水烧开
                laoWang.join();
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            // 水开了、茶叶也有了、壶杯都洗好了,汇合泡茶
            log.debug("泡茶");
        }, "小王");

        laoWang.start();
        xiaoWang.start();
    }
}
整个过程约 16 秒(对应 16 分钟)完成,与办法甲吻合。这就是多线程统筹规划的思想:理清任务间的依赖关系,让能并行的工作在等待期间并行完成。
本章小结
本章重点在于掌握:
- 线程创建:Thread、Runnable、FutureTask(Callable)三种方式;
- 线程重要 API:start、run、sleep、yield、join、interrupt 等;
- 线程状态:操作系统层面的五种状态与 Java API 层面的六种状态。
应用方面:
- 异步调用:主线程执行期间,其它线程异步执行耗时操作;
- 提高效率:并行计算,缩短运算时间;
- 同步等待:join;
- 统筹规划:合理使用线程,得到最优效果。
原理方面:
- 线程运行流程:栈、栈帧、上下文切换、程序计数器;
- Thread 两种创建方式的源码。