
08线程池
线程池是「共享模型之工具」中最重要的组件。线程的创建和销毁都需要开销,如果为每个任务都新建一个线程,在高并发场景下会消耗大量系统资源。线程池通过预先创建并复用一批线程来执行任务,做到:
- 降低资源消耗:线程重复利用,减少线程创建、销毁的开销
- 提高响应速度:任务到达时不必等待线程创建就能立即执行
- 提高线程的可管理性:线程统一分配、调优和监控
本篇先从一个自定义线程池入手,理解线程池的组成,再学习 JDK 提供的 ThreadPoolExecutor、Executors 工厂方法,最后了解 Fork/Join 分治框架。
自定义线程池
线程池的核心组成其实只有两部分:
- 阻塞队列:核心线程都在忙时,新任务先进入队列排队等待
- 线程集合(Worker):线程池中工作的线程,不断从队列中取任务执行
当队列也满了怎么办?这就需要拒绝策略来决定如何处理新任务。下面分四步实现一个自定义线程池。
定义拒绝策略接口
拒绝策略只做一件事:队列满时,把队列和当前任务交给策略实现者处理。
@FunctionalInterface // 拒绝策略
interface RejectPolicy<T> {
    void reject(BlockingQueue<T> queue, T task);
}
具体是死等、超时等待、放弃任务、抛异常还是让调用者自己执行,都由这个接口的不同实现决定。
自定义任务队列
任务队列基于 ReentrantLock + 两个 Condition 实现:生产者在队列满时等待,消费者在队列空时等待,类似生产者-消费者模式。
class BlockingQueue<T> {
    // 1. 任务队列
    private Deque<T> queue = new ArrayDeque<>();

    // 2. 锁
    private ReentrantLock lock = new ReentrantLock();

    // 3. 生产者条件变量
    private Condition fullWaitSet = lock.newCondition();

    // 4. 消费者条件变量
    private Condition emptyWaitSet = lock.newCondition();

    // 5. 容量
    private int capcity;

    public BlockingQueue(int capcity) {
        this.capcity = capcity;
    }

    // 带超时阻塞获取
    public T poll(long timeout, TimeUnit unit) {
        lock.lock();
        try {
            // 将 timeout 统一转换为 纳秒
            long nanos = unit.toNanos(timeout);
            while (queue.isEmpty()) {
                try {
                    // 返回值是剩余时间
                    if (nanos <= 0) {
                        return null;
                    }
                    nanos = emptyWaitSet.awaitNanos(nanos);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            T t = queue.removeFirst();
            fullWaitSet.signal();
            return t;
        } finally {
            lock.unlock();
        }
    }

    // 阻塞获取
    public T take() {
        lock.lock();
        try {
            while (queue.isEmpty()) {
                try {
                    emptyWaitSet.await();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            T t = queue.removeFirst();
            fullWaitSet.signal();
            return t;
        } finally {
            lock.unlock();
        }
    }

    // 阻塞添加
    public void put(T task) {
        lock.lock();
        try {
            while (queue.size() == capcity) {
                try {
                    log.debug("等待加入任务队列 {} ...", task);
                    fullWaitSet.await();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            log.debug("加入任务队列 {}", task);
            queue.addLast(task);
            emptyWaitSet.signal();
        } finally {
            lock.unlock();
        }
    }

    // 带超时时间阻塞添加
    public boolean offer(T task, long timeout, TimeUnit timeUnit) {
        lock.lock();
        try {
            long nanos = timeUnit.toNanos(timeout);
            while (queue.size() == capcity) {
                try {
                    if (nanos <= 0) {
                        return false;
                    }
                    log.debug("等待加入任务队列 {} ...", task);
                    nanos = fullWaitSet.awaitNanos(nanos);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            log.debug("加入任务队列 {}", task);
            queue.addLast(task);
            emptyWaitSet.signal();
            return true;
        } finally {
            lock.unlock();
        }
    }

    public int size() {
        lock.lock();
        try {
            return queue.size();
        } finally {
            lock.unlock();
        }
    }

    public void tryPut(RejectPolicy<T> rejectPolicy, T task) {
        lock.lock();
        try {
            // 判断队列是否满
            if (queue.size() == capcity) {
                rejectPolicy.reject(this, task);
            } else {  // 有空闲
                log.debug("加入任务队列 {}", task);
                queue.addLast(task);
                emptyWaitSet.signal();
            }
        } finally {
            lock.unlock();
        }
    }
}
自定义线程池
线程池内部维护一个「任务队列」和一个「Worker 线程集合」:
- 任务数没有超过核心线程数
coreSize时,直接新建 Worker 执行 - 超过核心线程数时,任务交给
tryPut入队,队列满则执行拒绝策略 - Worker 执行完手头任务后,会继续从队列取任务;带超时时间取不到任务时,Worker 结束并被移出集合(相当于空闲线程被回收)
class ThreadPool {
    // 任务队列
    private BlockingQueue<Runnable> taskQueue;

    // 线程集合
    private HashSet<Worker> workers = new HashSet<>();

    // 核心线程数
    private int coreSize;

    // 获取任务时的超时时间
    private long timeout;

    private TimeUnit timeUnit;

    private RejectPolicy<Runnable> rejectPolicy;

    // 执行任务
    public void execute(Runnable task) {
        // 当任务数没有超过 coreSize 时,直接交给 worker 对象执行
        // 如果任务数超过 coreSize 时,加入任务队列暂存
        synchronized (workers) {
            if (workers.size() < coreSize) {
                Worker worker = new Worker(task);
                log.debug("新增 worker{}, {}", worker, task);
                workers.add(worker);
                worker.start();
            } else {
                // 1) 死等
                // 2) 带超时等待
                // 3) 让调用者放弃任务执行
                // 4) 让调用者抛出异常
                // 5) 让调用者自己执行任务
                taskQueue.tryPut(rejectPolicy, task);
            }
        }
    }

    public ThreadPool(int coreSize, long timeout, TimeUnit timeUnit, int queueCapcity,
                      RejectPolicy<Runnable> rejectPolicy) {
        this.coreSize = coreSize;
        this.timeout = timeout;
        this.timeUnit = timeUnit;
        this.taskQueue = new BlockingQueue<>(queueCapcity);
        this.rejectPolicy = rejectPolicy;
    }

    class Worker extends Thread {
        private Runnable task;

        public Worker(Runnable task) {
            this.task = task;
        }

        @Override
        public void run() {
            // 执行任务
            // 1) 当 task 不为空,执行任务
            // 2) 当 task 执行完毕,再接着从任务队列获取任务并执行
            while (task != null || (task = taskQueue.poll(timeout, timeUnit)) != null) {
                try {
                    log.debug("正在执行...{}", task);
                    task.run();
                } catch (Exception e) {
                    e.printStackTrace();
                } finally {
                    task = null;
                }
            }
            synchronized (workers) {
                log.debug("worker 被移除{}", this);
                workers.remove(this);
            }
        }
    }
}
测试
核心线程数 1、队列容量 1,连续提交 4 个任务。拒绝策略可以在 lambda 中灵活切换:
public static void main(String[] args) {
    ThreadPool threadPool = new ThreadPool(1,
            1000, TimeUnit.MILLISECONDS, 1, (queue, task) -> {
        // 1. 死等
//            queue.put(task);
        // 2) 带超时等待
//            queue.offer(task, 1500, TimeUnit.MILLISECONDS);
        // 3) 让调用者放弃任务执行
//            log.debug("放弃{}", task);
        // 4) 让调用者抛出异常
//            throw new RuntimeException("任务执行失败 " + task);
        // 5) 让调用者自己执行任务
        task.run();
    });
    for (int i = 0; i < 4; i++) {
        int j = i;
        threadPool.execute(() -> {
            try {
                Thread.sleep(1000L);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            log.debug("{}", j);
        });
    }
}
这个自定义实现已经具备了 JDK 线程池的雏形:核心线程、阻塞队列、拒绝策略、空闲线程回收。下面来看 JDK 官方实现 ThreadPoolExecutor。
ThreadPoolExecutor
线程池状态
ThreadPoolExecutor 使用一个 int 的高 3 位表示线程池状态,低 29 位表示线程数量。
| 状态名 | 高 3 位 | 接收新任务 | 处理阻塞队列任务 | 说明 |
|---|---|---|---|---|
| RUNNING | 111 | Y | Y | 正常运行 |
| SHUTDOWN | 000 | N | Y | 不会接收新任务,但会处理阻塞队列剩余任务 |
| STOP | 001 | N | N | 会中断正在执行的任务,并抛弃阻塞队列任务 |
| TIDYING | 010 | - | - | 任务全执行完毕,活动线程为 0,即将进入终结 |
| TERMINATED | 011 | - | - | 终结状态 |
从数字上比较:TERMINATED > TIDYING > STOP > SHUTDOWN > RUNNING。
这些信息存储在一个原子变量 ctl 中,目的是将线程池状态与线程个数合二为一,这样就可以用一次 CAS 原子操作进行赋值:
// c 为旧值, ctlOf 返回结果为新值
ctl.compareAndSet(c, ctlOf(targetState, workerCountOf(c)));

// rs 为高 3 位代表线程池状态, wc 为低 29 位代表线程个数,ctl 是合并它们
private static int ctlOf(int rs, int wc) { return rs | wc; }
构造方法的七大参数
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          ThreadFactory threadFactory,
                          RejectedExecutionHandler handler)
七大参数含义:
corePoolSize:核心线程数目(最多保留的线程数)maximumPoolSize:最大线程数目keepAliveTime:生存时间,针对救急线程unit:时间单位,针对救急线程workQueue:阻塞队列threadFactory:线程工厂,可以为线程创建时起个好名字,便于排查问题handler:拒绝策略
线程池的工作方式
线程池中刚开始没有线程,当一个任务提交给线程池后,线程池会创建一个新线程来执行任务。整个调度流程如下:
- 当线程数达到
corePoolSize并且没有线程空闲时,再加入的任务会被加入workQueue队列排队,直到有空闲线程 - 如果队列选择了有界队列,任务超过队列容量时,会创建
maximumPoolSize - corePoolSize数目的线程来救急 - 如果线程数到达
maximumPoolSize仍然有新任务到来,这时会执行拒绝策略 - 高峰过去后,超过
corePoolSize的救急线程如果一段时间没有任务做,需要结束以节省资源,这个时间由keepAliveTime和unit控制
例如 corePoolSize = 2、maximumPoolSize = 3:核心线程 1、2 先被创建,任务 3、4 进入阻塞队列,队列满后创建救急线程 1。
四种拒绝策略
JDK 提供了 4 种拒绝策略实现,它们都实现了 RejectedExecutionHandler 接口:
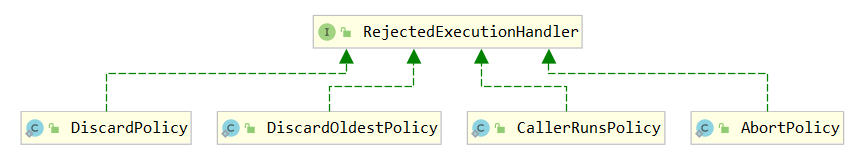
AbortPolicy:让调用者抛出RejectedExecutionException异常,这是默认策略CallerRunsPolicy:让调用者自己运行任务DiscardPolicy:放弃本次任务DiscardOldestPolicy:放弃队列中最早的任务,本任务取而代之
其它著名框架也提供了各自的实现:
- Dubbo:在抛出
RejectedExecutionException异常之前会记录日志,并 dump 线程栈信息,方便定位问题 - Netty:创建一个新线程来执行任务
- ActiveMQ:带超时等待(60s)尝试放入队列,类似自定义线程池中的带超时等待
- PinPoint:使用一个拒绝策略链,会逐一尝试策略链中的每种拒绝策略
类继承体系
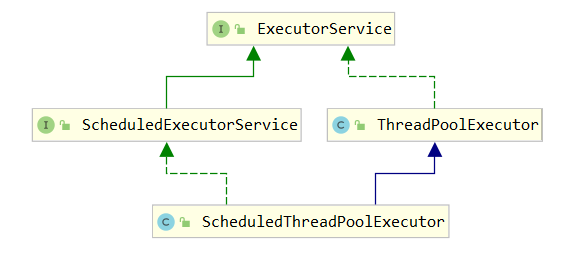
Executor:所有线程池的根接口,只有一个execute方法ExecutorService:扩展了提交任务、关闭线程池等能力ThreadPoolExecutor:最常用的线程池实现ScheduledExecutorService:扩展了延迟执行、周期执行能力,由ScheduledThreadPoolExecutor实现
Executors 工厂方法
ThreadPoolExecutor 的参数较多,JDK 的 Executors 类提供了众多工厂方法来创建各种用途的线程池。但需要注意,《阿里巴巴 Java 开发手册》中并不推荐使用这些工厂方法(队列或线程数无界可能导致 OOM),生产环境更建议用 ThreadPoolExecutor 构造方法显式指定参数。
newFixedThreadPool
public static ExecutorService newFixedThreadPool(int nThreads) {
    return new ThreadPoolExecutor(nThreads, nThreads,
                                  0L, TimeUnit.MILLISECONDS,
                                  new LinkedBlockingQueue<Runnable>());
}
特点:
- 核心线程数 == 最大线程数(没有救急线程被创建),因此也无需超时时间
- 阻塞队列是无界的,可以放任意数量的任务
评价:适用于任务量已知、相对耗时的任务。
newCachedThreadPool
public static ExecutorService newCachedThreadPool() {
    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                  60L, TimeUnit.SECONDS,
                                  new SynchronousQueue<Runnable>());
}
特点:
- 核心线程数是 0,最大线程数是
Integer.MAX_VALUE,救急线程的空闲生存时间是 60s,意味着全部都是救急线程(60s 后可以回收),且救急线程可以无限创建 - 队列采用了
SynchronousQueue,特点是没有容量,没有线程来取是放不进去的(一手交钱、一手交货)
SynchronousQueue 的交接效果:
SynchronousQueue<Integer> integers = new SynchronousQueue<>();
new Thread(() -> {
    try {
        log.debug("putting {} ", 1);
        integers.put(1);
        log.debug("{} putted...", 1);

        log.debug("putting...{} ", 2);
        integers.put(2);
        log.debug("{} putted...", 2);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
}, "t1").start();

sleep(1);

new Thread(() -> {
    try {
        log.debug("taking {}", 1);
        integers.take();
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
}, "t2").start();

sleep(1);

new Thread(() -> {
    try {
        log.debug("taking {}", 2);
        integers.take();
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
}, "t3").start();
输出:
11:48:15.500 c.TestSynchronousQueue [t1] - putting 1
11:48:16.500 c.TestSynchronousQueue [t2] - taking 1
11:48:16.500 c.TestSynchronousQueue [t1] - 1 putted...
11:48:16.500 c.TestSynchronousQueue [t1] - putting...2
11:48:17.502 c.TestSynchronousQueue [t3] - taking 2
11:48:17.503 c.TestSynchronousQueue [t1] - 2 putted...
评价:整个线程池表现为线程数会根据任务量不断增长,没有上限;当任务执行完毕,空闲 1 分钟后释放线程。适合任务数比较密集、但每个任务执行时间较短的情况。
newSingleThreadExecutor
public static ExecutorService newSingleThreadExecutor() {
    return new FinalizableDelegatedExecutorService
        (new ThreadPoolExecutor(1, 1,
                                0L, TimeUnit.MILLISECONDS,
                                new LinkedBlockingQueue<Runnable>()));
}
使用场景:希望多个任务排队执行。线程数固定为 1,任务数多于 1 时会放入无界队列排队,任务执行完毕,这唯一的线程也不会被释放。
和「自己创建一个单线程串行执行」的区别:
- 自己创建单线程执行任务,如果任务执行失败导致线程终止,没有任何补救措施;而线程池在唯一线程异常结束后还会再新建一个线程,保证池的正常工作
Executors.newSingleThreadExecutor()线程个数始终为 1,且不能修改。它外面套了一层FinalizableDelegatedExecutorService(装饰器模式),只对外暴露ExecutorService接口,因此不能调用ThreadPoolExecutor中特有的方法Executors.newFixedThreadPool(1)初始线程数为 1,以后还可以修改。它对外暴露的是ThreadPoolExecutor对象,可以强转后调用setCorePoolSize等方法修改
提交任务
// 执行任务
void execute(Runnable command);

// 提交任务 task,用返回值 Future 获得任务执行结果
<T> Future<T> submit(Callable<T> task);

// 提交 tasks 中所有任务
<T> List<Future<T>> invokeAll(Collection<? extends Callable<T>> tasks)
        throws InterruptedException;

// 提交 tasks 中所有任务,带超时时间
<T> List<Future<T>> invokeAll(Collection<? extends Callable<T>> tasks,
                              long timeout, TimeUnit unit)
        throws InterruptedException;

// 提交 tasks 中所有任务,哪个任务先成功执行完毕,返回此任务执行结果,其它任务取消
<T> T invokeAny(Collection<? extends Callable<T>> tasks)
        throws InterruptedException, ExecutionException;

// 同上,带超时时间
<T> T invokeAny(Collection<? extends Callable<T>> tasks,
                long timeout, TimeUnit unit)
        throws InterruptedException, ExecutionException, TimeoutException;
区别总结:
execute只执行Runnable,没有返回值submit可以提交Callable,通过返回的Future获取结果(或异常)invokeAll等待所有任务完成,返回每个任务的FutureinvokeAny只要有一个任务成功完成,就返回它的结果,其它任务取消
关闭线程池
shutdown
/*
线程池状态变为 SHUTDOWN
 - 不会接收新任务
 - 但已提交任务会执行完
 - 此方法不会阻塞调用线程的执行
*/
void shutdown();

public void shutdown() {
    final ReentrantLock mainLock = this.mainLock;
    mainLock.lock();
    try {
        checkShutdownAccess();
        // 修改线程池状态
        advanceRunState(SHUTDOWN);
        // 仅会打断空闲线程
        interruptIdleWorkers();
        onShutdown(); // 扩展点 ScheduledThreadPoolExecutor
    } finally {
        mainLock.unlock();
    }
    // 尝试终结(没有运行的线程可以立刻终结,如果还有运行的线程也不会等)
    tryTerminate();
}
shutdownNow
/*
线程池状态变为 STOP
 - 不会接收新任务
 - 会将队列中的任务返回
 - 并用 interrupt 的方式中断正在执行的任务
*/
List<Runnable> shutdownNow();

public List<Runnable> shutdownNow() {
    List<Runnable> tasks;
    final ReentrantLock mainLock = this.mainLock;
    mainLock.lock();
    try {
        checkShutdownAccess();
        // 修改线程池状态
        advanceRunState(STOP);
        // 打断所有线程
        interruptWorkers();
        // 获取队列中剩余任务
        tasks = drainQueue();
    } finally {
        mainLock.unlock();
    }
    // 尝试终结
    tryTerminate();
    return tasks;
}
其它方法
// 不在 RUNNING 状态的线程池,此方法就返回 true
boolean isShutdown();

// 线程池状态是否是 TERMINATED
boolean isTerminated();

// 调用 shutdown 后,由于调用线程并不会等待所有任务运行结束,
// 因此如果它想在线程池 TERMINATED 后做些事情,可以利用此方法等待
boolean awaitTermination(long timeout, TimeUnit unit) throws InterruptedException;
任务调度线程池
在任务调度线程池出现之前,可以使用 java.util.Timer 实现定时功能。Timer 简单易用,但所有任务都由同一个线程调度,任务串行执行,同一时间只能有一个任务在执行,前一个任务的延迟或异常都会影响之后的任务:
public static void main(String[] args) {
    Timer timer = new Timer();
    TimerTask task1 = new TimerTask() {
        @Override
        public void run() {
            log.debug("task 1");
            sleep(2);
        }
    };
    TimerTask task2 = new TimerTask() {
        @Override
        public void run() {
            log.debug("task 2");
        }
    };
    // 使用 timer 添加两个任务,希望它们都在 1s 后执行
    // 但由于 timer 内只有一个线程来顺序执行队列中的任务,因此『任务1』的延时,影响了『任务2』的执行
    timer.schedule(task1, 1000);
    timer.schedule(task2, 1000);
}
可以看到两个任务本应都在 1s 后执行,但 task2 被 task1 拖到了 2s 后:
20:46:09.444 c.TestTimer [main] - start...
20:46:10.447 c.TestTimer [Timer-0] - task 1
20:46:12.448 c.TestTimer [Timer-0] - task 2
使用 ScheduledExecutorService 改写,两个任务互不影响:
ScheduledExecutorService executor = Executors.newScheduledThreadPool(2);
// 添加两个任务,希望它们都在 1s 后执行
executor.schedule(() -> {
    System.out.println("任务1,执行时间:" + new Date());
    try { Thread.sleep(2000); } catch (InterruptedException e) { }
}, 1000, TimeUnit.MILLISECONDS);
executor.schedule(() -> {
    System.out.println("任务2,执行时间:" + new Date());
}, 1000, TimeUnit.MILLISECONDS);
scheduleAtFixedRate 按固定频率执行。如果任务执行时间超过了间隔时间,间隔会被「撑」到任务执行时长:
ScheduledExecutorService pool = Executors.newScheduledThreadPool(1);
log.debug("start...");
pool.scheduleAtFixedRate(() -> {
    log.debug("running...");
    sleep(2); // 任务耗时 2s
}, 1, 1, TimeUnit.SECONDS);
// 实际输出间隔为 2s:任务执行时间 > 间隔时间
scheduleWithFixedDelay 按固定延迟执行,间隔是「上一个任务结束」到「下一个任务开始」之间的时间。任务耗时 2s、延迟 1s 时,每次间隔都是 3s:
ScheduledExecutorService pool = Executors.newScheduledThreadPool(1);
log.debug("start...");
pool.scheduleWithFixedDelay(() -> {
    log.debug("running...");
    sleep(2);
}, 1, 1, TimeUnit.SECONDS);
正确处理执行任务异常
线程池中任务抛出的异常默认会被「吞掉」,需要主动处理。
方法 1:主动捉异常:
ExecutorService pool = Executors.newFixedThreadPool(1);
pool.submit(() -> {
    try {
        log.debug("task1");
        int i = 1 / 0;
    } catch (Exception e) {
        log.error("error:", e);
    }
});
方法 2:使用 Future,异常会被封装进执行结果,调用 get() 时抛出:
ExecutorService pool = Executors.newFixedThreadPool(1);
Future<Boolean> f = pool.submit(() -> {
    log.debug("task1");
    int i = 1 / 0;
    return true;
});
log.debug("result:{}", f.get());
输出:
Exception in thread "main" java.util.concurrent.ExecutionException: java.lang.ArithmeticException: / by zero
    at java.util.concurrent.FutureTask.report(FutureTask.java:122)
    at java.util.concurrent.FutureTask.get(FutureTask.java:192)
    ...
Caused by: java.lang.ArithmeticException: / by zero
    ...
扩展:Tomcat 线程池
Tomcat 中也大量使用线程池处理请求:
LimitLatch:用来限流,可以控制最大连接个数,类似 JUC 中的SemaphoreAcceptor:只负责接收新的 socket 连接Poller:只负责监听 socket channel 是否有可读的 I/O 事件- 一旦可读,封装一个任务对象(
socketProcessor),提交给Executor线程池处理 Executor线程池中的工作线程最终负责处理请求
Tomcat 线程池扩展了 ThreadPoolExecutor,行为稍有不同:如果总线程数达到 maximumPoolSize,不会立刻抛 RejectedExecutionException,而是再次尝试将任务放入队列,如果还失败,才抛出异常:
public void execute(Runnable command, long timeout, TimeUnit unit) {
    submittedCount.incrementAndGet();
    try {
        super.execute(command);
    } catch (RejectedExecutionException rx) {
        if (super.getQueue() instanceof TaskQueue) {
            final TaskQueue queue = (TaskQueue) super.getQueue();
            try {
                if (!queue.force(command, timeout, unit)) {
                    submittedCount.decrementAndGet();
                    throw new RejectedExecutionException("Queue capacity is full.");
                }
            } catch (InterruptedException x) {
                submittedCount.decrementAndGet();
                Thread.interrupted();
                throw new RejectedExecutionException(x);
            }
        } else {
            submittedCount.decrementAndGet();
            throw rx;
        }
    }
}
Connector 与 Executor 的常用配置:
| 配置项 | 默认值 | 说明 |
|---|---|---|
| acceptorThreadCount | 1 | acceptor 线程数量 |
| pollerThreadCount | 1 | poller 线程数量 |
| minSpareThreads | 10 / 25 | 核心线程数,即 corePoolSize |
| maxThreads | 200 | 最大线程数,即 maximumPoolSize |
| maxIdleTime | 60000 | 线程生存时间,单位毫秒,默认 1 分钟 |
| maxQueueSize | Integer.MAX_VALUE | 队列长度 |
| daemon | true | 是否守护线程 |
创建多少线程合适
线程池大小设置不合理,过小会浪费 CPU,过大可能增加上下文切换开销。设置多少线程取决于任务类型。
CPU 密集型运算
CPU 密集型任务(计算、编码、压缩等)几乎不发生线程等待,线程数应当紧密贴合 CPU 核心数。经验公式:
线程数 = CPU 核心数 + 1多出的 1 个线程,是为了在某个线程偶尔因为缺页中断等原因暂停时,CPU 仍然有事可做。
可以通过下面代码获取核心数:
Runtime.getRuntime().availableProcessors();IO 密集型运算
IO 密集型任务(读写数据库、网络调用、文件读写等)线程经常处于等待状态,CPU 在等待期间可以去执行别的线程。常见经验值:
线程数 = CPU 核心数 × 2更精确的公式依据「等待时间与计算时间的比值」:
线程数 = CPU 核心数 × (1 + 平均等待时间 / 平均计算时间)例如 4 核 CPU,任务计算耗时 1s、IO 等待耗时 9s,则理论线程数为 4 × (1 + 9/1) = 40。
实际项目中还要结合压测不断调整,上述公式只提供初始参考值。
Fork/Join
概念
Fork/Join 是 JDK 1.7 加入的线程池实现,它体现的是一种分治思想,适用于能够进行任务拆分的 CPU 密集型运算:
- 所谓任务拆分,是将一个大任务拆分为算法上相同的小任务,直至不能拆分、可以直接求解。跟递归相关的计算,如归并排序、斐波那契数列,都可以用分治思想求解
- Fork/Join 在分治基础上加入了多线程,可以把每个任务的分解和合并交给不同线程完成,进一步提升运算效率
- Fork/Join 默认会创建与 CPU 核心数大小相同的线程池
提交给 Fork/Join 线程池的任务需要继承 RecursiveTask(有返回值)或 RecursiveAction(没有返回值)。
分治求和(初步实现)
定义一个对 1~n 之间整数求和的任务:
@Slf4j(topic = "c.AddTask")
class AddTask1 extends RecursiveTask<Integer> {

    int n;

    public AddTask1(int n) {
        this.n = n;
    }

    @Override
    public String toString() {
        return "{" + n + '}';
    }

    @Override
    protected Integer compute() {
        // 如果 n 已经为 1,可以求得结果了
        if (n == 1) {
            log.debug("join() {}", n);
            return n;
        }

        // 将任务进行拆分(fork)
        AddTask1 t1 = new AddTask1(n - 1);
        t1.fork();
        log.debug("fork() {} + {}", n, t1);

        // 合并(join)结果
        int result = n + t1.join();
        log.debug("join() {} + {} = {}", n, t1, result);
        return result;
    }
}
提交给 ForkJoinPool 执行:
public static void main(String[] args) {
    ForkJoinPool pool = new ForkJoinPool(4);
    System.out.println(pool.invoke(new AddTask1(5)));
}
结果:
[ForkJoinPool-1-worker-0] - fork() 2 + {1}
[ForkJoinPool-1-worker-1] - fork() 5 + {4}
[ForkJoinPool-1-worker-0] - join() 1
[ForkJoinPool-1-worker-0] - join() 2 + {1} = 3
[ForkJoinPool-1-worker-2] - fork() 4 + {3}
[ForkJoinPool-1-worker-3] - fork() 3 + {2}
[ForkJoinPool-1-worker-3] - join() 3 + {2} = 6
[ForkJoinPool-1-worker-2] - join() 4 + {3} = 10
[ForkJoinPool-1-worker-1] - join() 5 + {4} = 15
15
改进:二分拆分
上面的写法每个任务只拆出一个子任务(n-1),链式依赖比较长。改进为把区间从中间一分为二,更能体现分治:
class AddTask3 extends RecursiveTask<Integer> {

    int begin;
    int end;

    public AddTask3(int begin, int end) {
        this.begin = begin;
        this.end = end;
    }

    @Override
    public String toString() {
        return "{" + begin + "," + end + '}';
    }

    @Override
    protected Integer compute() {
        // 5, 5
        if (begin == end) {
            log.debug("join() {}", begin);
            return begin;
        }
        // 4, 5
        if (end - begin == 1) {
            log.debug("join() {} + {} = {}", begin, end, end + begin);
            return end + begin;
        }

        // 1 5
        int mid = (end + begin) / 2; // 3

        AddTask3 t1 = new AddTask3(begin, mid); // 1,3
        t1.fork();
        AddTask3 t2 = new AddTask3(mid + 1, end); // 4,5
        t2.fork();
        log.debug("fork() {} + {} = ?", t1, t2);

        int result = t1.join() + t2.join();
        log.debug("join() {} + {} = {}", t1, t2, result);
        return result;
    }
}
提交执行:
public static void main(String[] args) {
    ForkJoinPool pool = new ForkJoinPool(4);
    System.out.println(pool.invoke(new AddTask3(1, 10)));
}
结果:
[ForkJoinPool-1-worker-0] - join() 1 + 2 = 3
[ForkJoinPool-1-worker-3] - join() 4 + 5 = 9
[ForkJoinPool-1-worker-0] - join() 3
[ForkJoinPool-1-worker-1] - fork() {1,3} + {4,5} = ?
[ForkJoinPool-1-worker-2] - fork() {1,2} + {3,3} = ?
[ForkJoinPool-1-worker-2] - join() {1,2} + {3,3} = 6
[ForkJoinPool-1-worker-1] - join() {1,3} + {4,5} = 15
15
{1,5} 被拆成 {1,3} 和 {4,5},{1,3} 再拆成 {1,2} 和 {3,3},子任务并行执行后逐层 join 合并结果,这就是 Fork/Join 的基本用法。