
10线程安全集合
前面学习了各种锁和同步工具,本篇来梳理 JDK 中线程安全的集合类:它们是如何演进的,java.util.concurrent 包下的并发集合各有什么特点,以及实际使用中如何选择。
线程安全集合类概述
线程安全集合类可以分为三大类:
遗留的线程安全集合
早期 JDK 提供的 Hashtable、Vector,以及 Stack(继承自 Vector)。它们实现线程安全的方式非常粗暴——给大部分方法都加上 synchronized,相当于整个集合上一把大锁,多线程下串行度高、性能差,现在已不推荐使用。
Collections 装饰的同步集合
使用 Collections 提供的静态方法,把一个普通集合包装成线程安全集合:
Collections.synchronizedCollectionCollections.synchronizedListCollections.synchronizedMapCollections.synchronizedSetCollections.synchronizedNavigableMapCollections.synchronizedNavigableSetCollections.synchronizedSortedMapCollections.synchronizedSortedSet
例如:
List<String> list = Collections.synchronizedList(new ArrayList<>());
Map<String, String> map = Collections.synchronizedMap(new HashMap<>());
它的原理是在包装类的每个方法上都加 synchronized(默认以包装对象自身为锁),本质和 Vector/Hashtable 类似,同样是「大锁」方案,复合操作仍需要调用方手动加锁。
java.util.concurrent 并发集合
JUC 包下的并发集合,类名中包含三类关键词:Blocking、CopyOnWrite、Concurrent。
- Blocking:大部分实现基于锁,并提供用来阻塞的方法(阻塞队列)
- CopyOnWrite:写操作时复制底层数组,修改开销相对较重,适合读多写少
- Concurrent:内部很多操作使用 CAS 优化,一般可以提供较高吞吐量,但具有弱一致性的特点
Concurrent 类型容器的弱一致性体现在:
- 遍历弱一致:利用迭代器遍历时如果容器发生修改,迭代器仍可以继续遍历,看到的是旧内容
- 求大小弱一致:
size()操作未必 100% 准确 - 读取弱一致:读到的数据可能不是此刻最新的
对比之下,非线程安全容器在遍历时如果发生修改,会采用 fail-fast 机制让遍历立刻失败,抛出 ConcurrentModificationException,不再继续遍历。弱一致性用「短时间内数据可能稍旧」换取了更高的并发性能,这是并发集合刻意做出的权衡。
ConcurrentHashMap
ConcurrentHashMap 是并发场景下使用最广泛的 Map,用来替代 Hashtable 和 Collections.synchronizedMap。它的内部原理(JDK 7 的 Segment 分段锁、JDK 8 的 CAS + synchronized 锁桶)在原理篇另讲,这里通过一个经典练习来掌握它的用法。
练习:单词计数
生成测试数据
生成 26 个字母、每个字母 200 个,打乱后均分到 26 个小文件中:
static final String ALPHA = "abcedfghijklmnopqrstuvwxyz";

public static void main(String[] args) {
    int length = ALPHA.length();
    int count = 200;
    List<String> list = new ArrayList<>(length * count);
    for (int i = 0; i < length; i++) {
        char ch = ALPHA.charAt(i);
        for (int j = 0; j < count; j++) {
            list.add(String.valueOf(ch));
        }
    }
    Collections.shuffle(list);
    for (int i = 0; i < 26; i++) {
        try (PrintWriter out = new PrintWriter(
            new OutputStreamWriter(
                new FileOutputStream("tmp/" + (i + 1) + ".txt")))) {
            String collect = list.subList(i * count, (i + 1) * count).stream()
                .collect(Collectors.joining("\n"));
            out.print(collect);
        } catch (IOException e) {
        }
    }
}
模版代码
模版代码封装了 26 个线程并发读取文件的逻辑,调用者只需提供两个参数:一个用来存放计数结果的 Map,以及一组保证计数安全的操作:
private static <V> void demo(Supplier<Map<String, V>> supplier,
                              BiConsumer<Map<String, V>, List<String>> consumer) {
    Map<String, V> counterMap = supplier.get();
    List<Thread> ts = new ArrayList<>();
    for (int i = 1; i <= 26; i++) {
        int idx = i;
        Thread thread = new Thread(() -> {
            List<String> words = readFromFile(idx);
            consumer.accept(counterMap, words);
        });
        ts.add(thread);
    }

    ts.forEach(t -> t.start());
    ts.forEach(t -> {
        try {
            t.join();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    });

    System.out.println(counterMap);
}

public static List<String> readFromFile(int i) {
    ArrayList<String> words = new ArrayList<>();
    try (BufferedReader in = new BufferedReader(new InputStreamReader(new FileInputStream("tmp/"
        + i + ".txt")))) {
        while (true) {
            String word = in.readLine();
            if (word == null) {
                break;
            }
            words.add(word);
        }
        return words;
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
正确结果应该是每个单词出现 200 次:
{a=200, b=200, c=200, ..., y=200, z=200}错误示范
下面的实现有什么问题?
demo(
    // 创建 map 集合
    // 创建 ConcurrentHashMap 对不对?
    () -> new HashMap<String, Integer>(),

    // 进行计数
    (map, words) -> {
        for (String word : words) {
            Integer counter = map.get(word);
            int newValue = counter == null ? 1 : counter + 1;
            map.put(word, newValue);
        }
    }
);
问题有两层:
- 使用普通
HashMap,并发put可能丢数据甚至在 JDK 7 中出现死循环 - 即使把 Map 换成
ConcurrentHashMap,get和put两步组合仍然不是原子操作,多线程下会丢失更新(两个线程同时读到旧值,各自 +1 后写回)
参考解答 1:LongAdder 做计数器
利用 computeIfAbsent 保证计数器只被创建一次,再用 LongAdder(高并发累加器)完成累加:
demo(
    () -> new ConcurrentHashMap<String, LongAdder>(),
    (map, words) -> {
        for (String word : words) {
            // 注意不能使用 putIfAbsent,此方法返回的是上一次的 value,首次调用返回 null
            map.computeIfAbsent(word, (key) -> new LongAdder()).increment();
        }
    }
);
参考解答 2:merge 函数式编程
ConcurrentHashMap 的 merge 方法把「不存在则放入、存在则合并」合成一个原子操作,无需额外的原子变量:
demo(
    () -> new ConcurrentHashMap<String, Integer>(),
    (map, words) -> {
        for (String word : words) {
            // 函数式编程,无需原子变量
            map.merge(word, 1, Integer::sum);
        }
    }
);
结论:ConcurrentHashMap 只保证单个方法(如 computeIfAbsent、merge、put)的线程安全,多个方法的复合操作仍要借助它的原子方法或外部加锁。
BlockingQueue 概述
阻塞队列是线程池中最核心的组件之一,它在普通队列基础上提供了阻塞式的存取方法:队列满时 put 阻塞、队列空时 take 阻塞,天然适合作生产者-消费者之间的解耦桥梁。
常用方法可以分为四组:
| 方法类型 | 抛出异常 | 返回特殊值 | 阻塞等待 | 带超时 |
|---|---|---|---|---|
| 入队 | add(e) |
offer(e) |
put(e) |
offer(e, timeout, unit) |
| 出队 | remove() |
poll() |
take() |
poll(timeout, unit) |
| 检查队首 | element() |
peek() |
- | - |
JUC 中常用的 BlockingQueue 实现:
| 实现类 | 特点 |
|---|---|
ArrayBlockingQueue |
有界,基于数组实现,构造时必须指定容量,内部一把 ReentrantLock,默认非公平 |
LinkedBlockingQueue |
基于链表,容量默认 Integer.MAX_VALUE(近乎无界),入队、出队两把锁,吞吐较高。Executors.newFixedThreadPool 使用的就是它 |
SynchronousQueue |
容量为 0,不存储元素,put 必须等待一个线程 take(直接交接)。Executors.newCachedThreadPool 使用它 |
PriorityBlockingQueue |
支持按优先级出队的无界阻塞队列,元素需要实现 Comparable 或传入 Comparator |
DelayQueue |
元素必须实现 Delayed,只有到期后才能被取出,可用于定时任务、订单超时关闭等场景 |
LinkedTransferQueue |
LinkedBlockingQueue + SynchronousQueue 的结合体,transfer(e) 可以直接把元素交给等待的消费者,无人接收时再入队 |
选型建议:
- 资源、任务数需要严格受控时,优先选有界的
ArrayBlockingQueue或指定容量的LinkedBlockingQueue,避免无界队列在消费跟不上生产时无限堆积导致 OOM - 任务直接交给工作线程、希望线程数弹性伸缩时,考虑
SynchronousQueue - 需要延迟或优先级调度时,再考虑
DelayQueue/PriorityBlockingQueue
BlockingQueue 内部加锁与通知的实现原理在原理篇另讲。
ConcurrentLinkedQueue
ConcurrentLinkedQueue 是一个基于链表的无界非阻塞并发队列,不使用锁,而是通过 CAS 实现线程安全:
- 设计与
LinkedBlockingQueue非常像:dummy(哨兵)节点的引入让入队和出队操作锁住的是不同对象,同一时刻可以允许一个生产者和一个消费者并发执行 - 区别在于 LinkedBlockingQueue 用的是锁,而 ConcurrentLinkedQueue 的这两把「锁」用 CAS 实现
ConcurrentLinkedQueue 应用非常广泛,例如前面讲 Tomcat 的 Connector 结构时,Acceptor 作为生产者向 Poller 消费者传递事件信息,正是采用了 ConcurrentLinkedQueue 将 SocketChannel 交给 Poller 使用。
CopyOnWriteArrayList
CopyOnWriteArrayList 是 List 在并发场景下的实现,CopyOnWriteArraySet 是它的「马甲」(内部持有一个 CopyOnWriteArrayList)。
底层采用**写入时拷贝(Copy-On-Write)**的思想:增删改操作会将底层数组拷贝一份,更改操作在新数组上执行,不影响其它线程的并发读,读写分离。以新增为例(Java 11 源码,Java 8 中使用的是可重入锁而不是 synchronized):
public boolean add(E e) {
    synchronized (lock) {
        // 获取旧的数组
        Object[] es = getArray();
        int len = es.length;
        // 拷贝新的数组(这里是比较耗时的操作,但不影响其它读线程)
        es = Arrays.copyOf(es, len + 1);
        // 添加新元素
        es[len] = e;
        // 替换旧的数组
        setArray(es);
        return true;
    }
}
而其它读操作并未加锁,例如:
public void forEach(Consumer<? super E> action) {
    Objects.requireNonNull(action);
    for (Object x : getArray()) {
        @SuppressWarnings("unchecked") E e = (E) x;
        action.accept(e);
    }
}
get 弱一致性
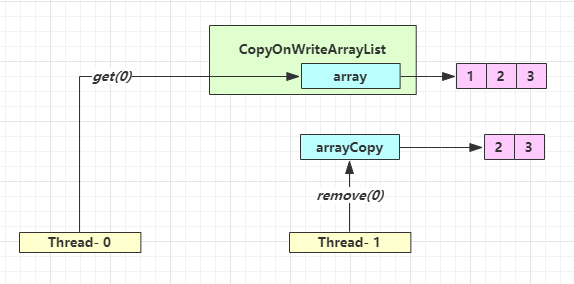
如上图所示:Thread-0 先执行 getArray() 拿到旧数组引用并准备 get(0),此时 Thread-1 执行 remove(0),拷贝出新数组 [2, 3] 并替换。Thread-0 之后仍然访问的是旧数组,因此读到的还是旧值 1:
| 时间点 | 操作 |
|---|---|
| 1 | Thread-0 getArray() |
| 2 | Thread-1 getArray() |
| 3 | Thread-1 setArray(arrayCopy) |
| 4 | Thread-0 array[index] |
这种问题不容易测试,但确实存在。
迭代器弱一致性
CopyOnWriteArrayList<Integer> list = new CopyOnWriteArrayList<>();
list.add(1);
list.add(2);
list.add(3);
Iterator<Integer> iter = list.iterator();
new Thread(() -> {
    list.remove(0);
    System.out.println(list); // [2, 3]
}).start();

sleep1s();
while (iter.hasNext()) {
    System.out.println(iter.next()); // 仍输出 1 2 3
}
迭代器遍历的是创建迭代器时的旧数组快照,遍历期间其它线程的修改不会被看到,也不会抛出 ConcurrentModificationException。
适用场景与权衡
- 适合读多写少的应用场景:读完全无锁,性能很高;写时要复制整个数组,数组越大开销越大
- 不要觉得弱一致性就不好:数据库的 MVCC 本质上也是弱一致性的表现,读到快照
- 并发高和一致性是矛盾的,需要根据业务权衡:能容忍短时间读到旧数据时,CopyOnWriteArrayList 是很好的选择;要求强一致的场景则应当使用加锁方案
小结
| 集合类型 | 代表类 | 实现思路 | 适用场景 |
|---|---|---|---|
| 遗留安全集合 | Vector、Hashtable | 方法级 synchronized 大锁 | 已淘汰 |
| 同步包装 | Collections.synchronizedXxx | 包装类加锁 | 兼容旧代码 |
| Concurrent | ConcurrentHashMap、ConcurrentLinkedQueue | CAS + 局部锁,弱一致 | 高并发、高吞吐 |
| Blocking | ArrayBlockingQueue、LinkedBlockingQueue 等 | 锁 + 阻塞等待 | 线程池、生产者消费者 |
| CopyOnWrite | CopyOnWriteArrayList / Set | 写入时复制,读无锁 | 读多写少、可容忍弱一致 |