
11Java内存模型与volatile原理
在应用篇中,我们已经从现象层面了解了 JMM 的三大特性:原子性、可见性与有序性,也知道 volatile 可以保证可见性、禁止指令重排。本篇是原理篇,将一路下沉到 CPU 硬件:先搞清楚现代 CPU 为什么会做指令级并行、为什么要有多级缓存,再理解多核之间如何通过 MESI 协议保持缓存一致,最终回答两个问题——内存屏障到底做了什么、volatile 和 final 在字节码与硬件层面是如何实现的。
指令级并行原理
基本名词:时钟周期、CPI 与 IPC
Clock Cycle Time(时钟周期时间) 等于 CPU 主频的倒数,是 CPU 能够识别的最小时间单位。例如 4GHz 主频的 CPU,一个时钟周期只有 0.25ns;作为对比,墙上挂钟的一个 Cycle Time 是 1s。通常运行一条加法指令需要一个时钟周期。
不同指令需要的时钟周期数不同,于是引出:
- CPI(Cycles Per Instruction):每条指令的平均时钟周期数
- IPC(Instruction Per Clock Cycle):CPI 的倒数,表示每个时钟周期能够执行的指令数
于是程序的 CPU 执行时间可以用下面的公式表示:
程序 CPU 执行时间 = 指令数 × CPI × Clock Cycle Time这也是所有 CPU 性能优化的出发点:减少指令数、降低 CPI(提高 IPC)、提高主频。而指令级并行(Instruction-Level Parallelism,ILP)正是降低 CPI 的核心手段。
鱼罐头的故事
用一个生活化的例子来理解流水线。加工一条鱼罐头需要 50 分钟,如果只能一条鱼、一条鱼地顺序加工,吞吐率就是每 50 分钟一条:
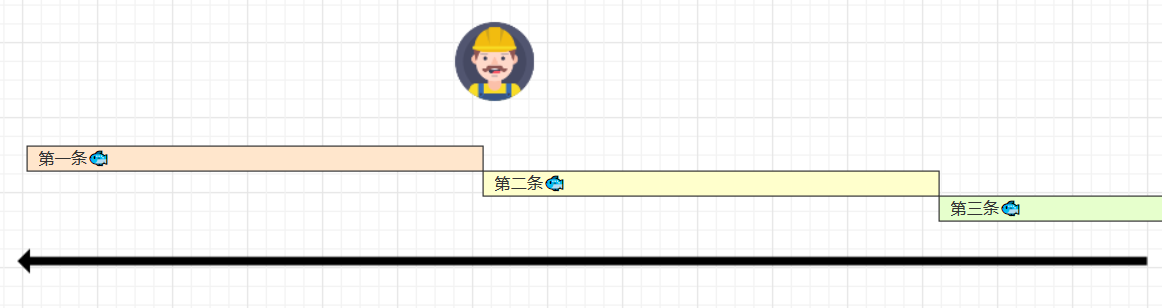
但把每条鱼的加工流程细分为 5 个步骤,每步 10 分钟:
- 去鳞清洗 10 分钟
- 蒸煮沥水 10 分钟
- 加注汤料 10 分钟
- 杀菌出锅 10 分钟
- 真空封罐 10 分钟
即使只有一个工人,最理想的情况也是:他能在 10 分钟内同时推进这 5 件事——对第一条鱼的真空封罐,并不会影响对第二条鱼的杀菌出锅。第一条鱼仍需 50 分钟,但从第一条鱼之后,每 10 分钟就能产出一条:
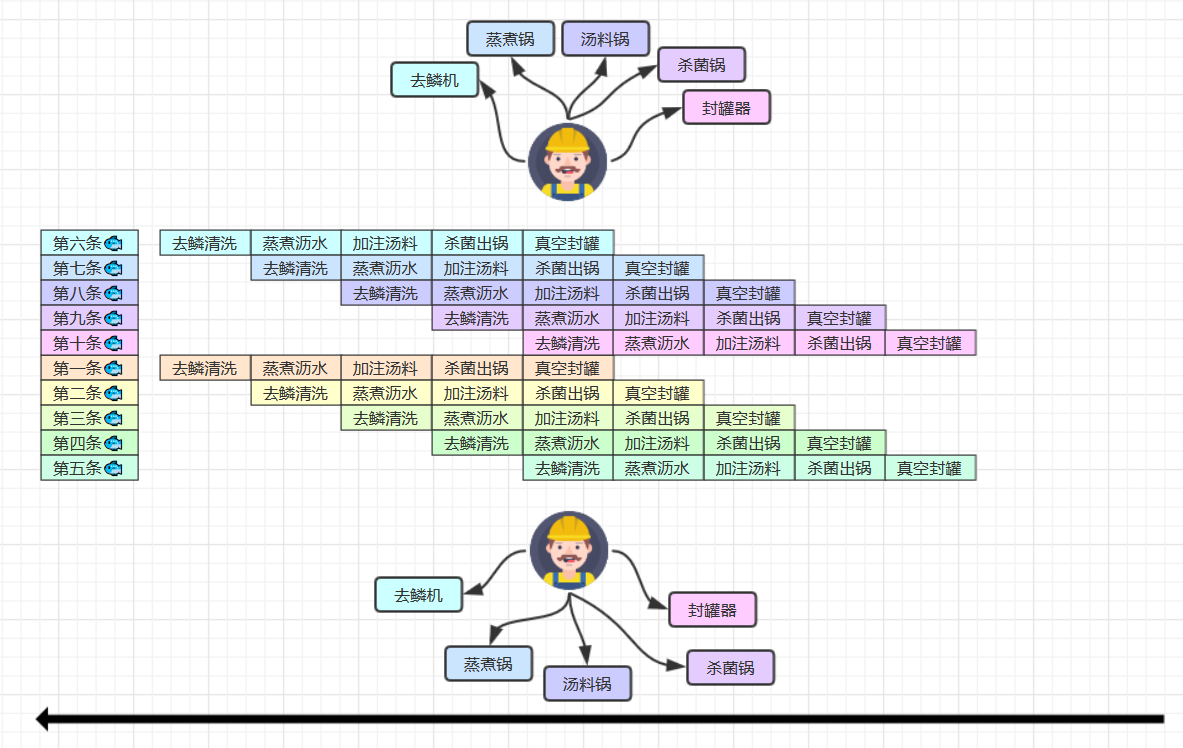
分阶段、分工,是提升效率的关键。CPU 的指令流水线与鱼罐头流水线本质上是同一个思想。
指令重排序优化
现代处理器被设计为一个时钟周期完成一条执行时间最长的 CPU 指令。这是因为一条指令还可以再划分成更小的阶段,经典的五级划分是:
| 阶段 | 英文缩写 | 含义 |
|---|---|---|
| 取指令 | IF(instruction fetch) | 从内存读取指令 |
| 指令译码 | ID(instruction decode) | 解析指令要做什么 |
| 执行指令 | EX(execute) | 在运算单元中执行 |
| 内存访问 | MEM(memory access) | 读/写内存 |
| 数据写回 | WB(register write back) | 结果写回寄存器 |
在不改变程序结果的前提下,这些指令的各个阶段可以通过重排序和组合来实现指令级并行。这一技术在 80 年代中叶到 90 年代中叶的计算架构中占据了重要地位。
指令重排的前提是:重排不能影响单线程程序的执行结果(即 as-if-serial 语义):
// 可以重排的例子:两条写指令之间没有数据依赖
int a = 10; // 指令1
int b = 20; // 指令2
System.out.println(a + b);

// 不能重排的例子:指令2 依赖指令1 的结果
int a = 10;       // 指令1
int b = a - 5;    // 指令2,必须读到指令1 写入的 a
参考:记分牌算法(Scoreboarding)与 Tomasulo 算法(结合寄存器重命名)是实现乱序执行与指令级并行最经典的两种技术。
支持流水线的处理器
现代 CPU 支持多级指令流水线。五级流水线意味着 CPU 可以在一个时钟周期内,同时运行五条指令的不同阶段:
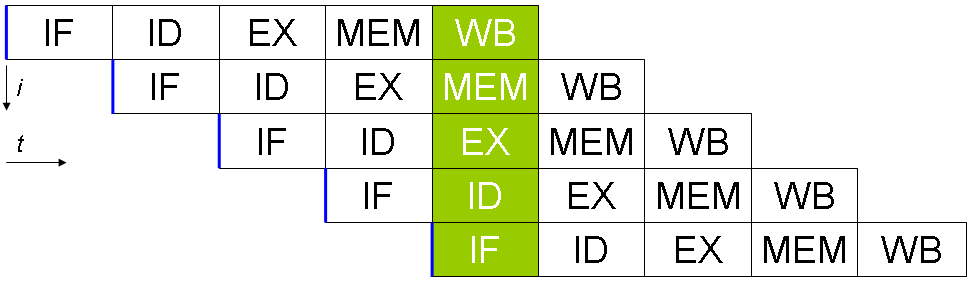
从图中可以看到,第一条指令要经过 5 个时钟周期才能写回,但进入稳定状态后,每个时钟周期都能完成一条指令,即 IPC = 1。
需要注意:流水线技术并不能缩短单条指令的执行时间,但它变相地提高了指令的吞吐率。流水线也不是级数越多越好——奔腾四(Pentium 4)曾支持高达 35 级流水线,但由于功耗太高、流水线清空代价过大,最终被废弃。
SuperScalar 超标量处理器
大多数处理器内部包含多个独立的执行单元,计算功能并不集中在一起,可以细分为整数运算单元、浮点数运算单元等。这样多条指令可以并行地获取、译码、执行,CPU 在一个时钟周期内可以执行多于一条指令,即 IPC > 1,这就是超标量(SuperScalar)技术:
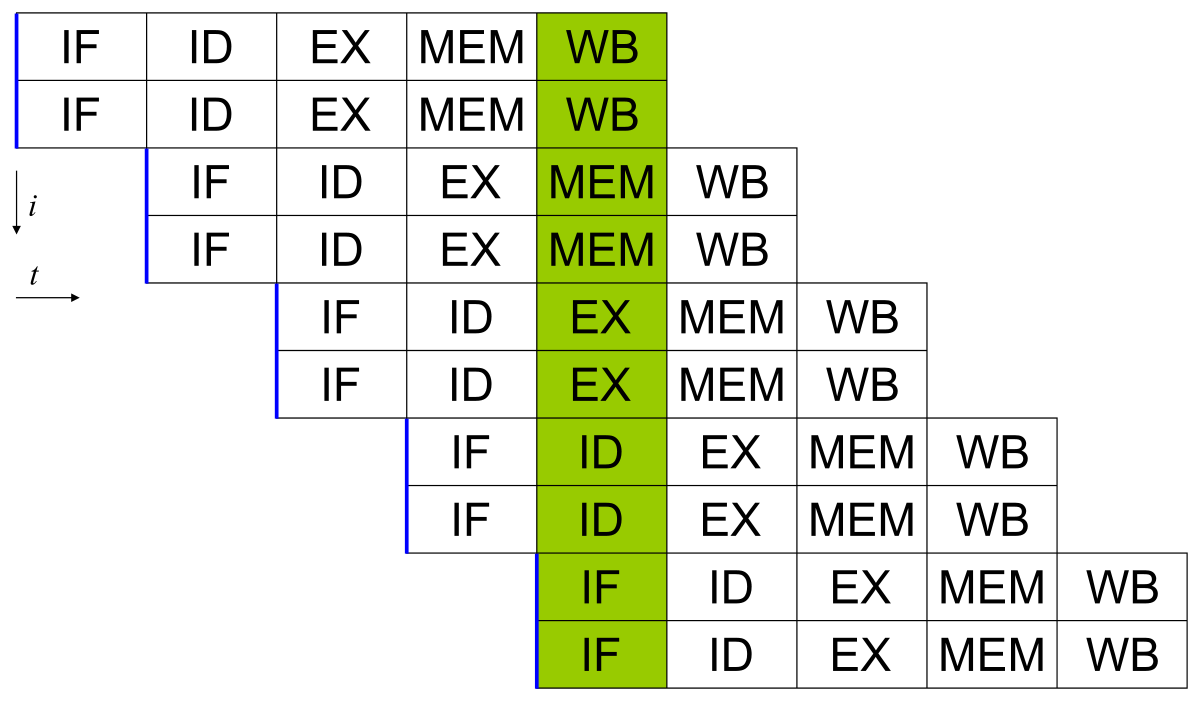
至此可以看到:为了追求性能,CPU 不仅会把一条指令切成多个阶段重叠执行,还会在保证结果不变的前提下调整指令顺序。这些硬件优化在单线程下是安全的,但在多核多线程共享数据时,就会带来可见性与有序性问题——这正是 JMM 要约束的东西。
CPU 缓存结构原理
CPU 缓存结构
CPU 的运算速度与主存的访问速度之间存在数量级的差距,于是在 CPU 与主存之间加入了多级缓存,越靠近 CPU 的缓存越快、也越小:
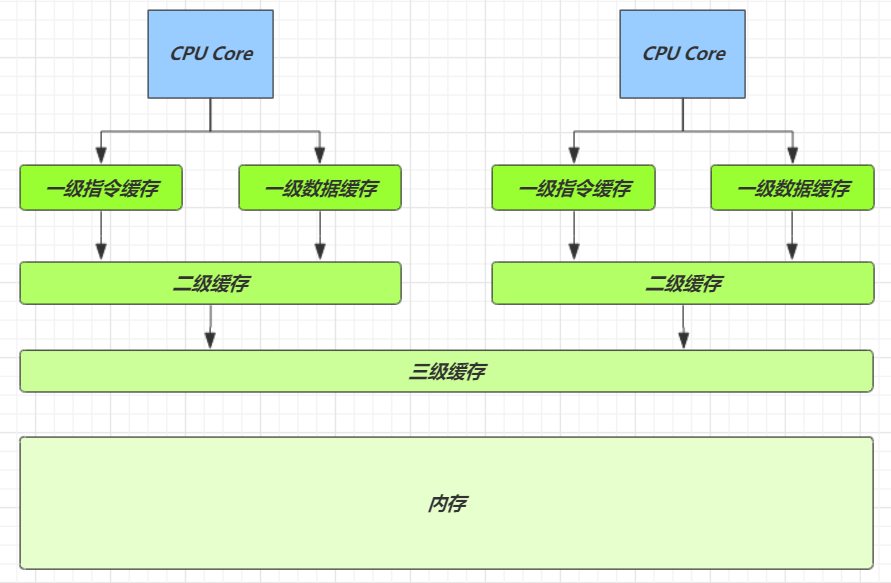
在 Linux 上可以用 lscpu 查看缓存信息:
L1d cache:             32K      # 一级数据缓存
L1i cache:             32K      # 一级指令缓存
L2 cache:              256K     # 二级缓存(每核私有)
L3 cache:              8192K    # 三级缓存(多核共享)
从 CPU 访问不同存储介质,大约需要的时钟周期如下:
| 存储介质 | 大约时钟周期 |
|---|---|
| 寄存器 | 1 cycle |
| L1 缓存 | 3~4 cycle |
| L2 缓存 | 10~20 cycle |
| L3 缓存 | 40~45 cycle |
| 内存 | 120~240 cycle |
缓存与内存之间按缓存行(Cache Line) 交换数据,可以通过下面的命令查看缓存行大小,x86 架构通常为 64 字节:
cat /sys/devices/system/cpu/cpu0/cache/index0/coherency_line_size
64
CPU 缓存读
缓存中的每一项(缓存行)至少包含:索引、有效位、组标记、数据。CPU 拿到的内存地址被划分为三段:
[ 高位组标记 ][ 低位索引 ][ 偏移量 ]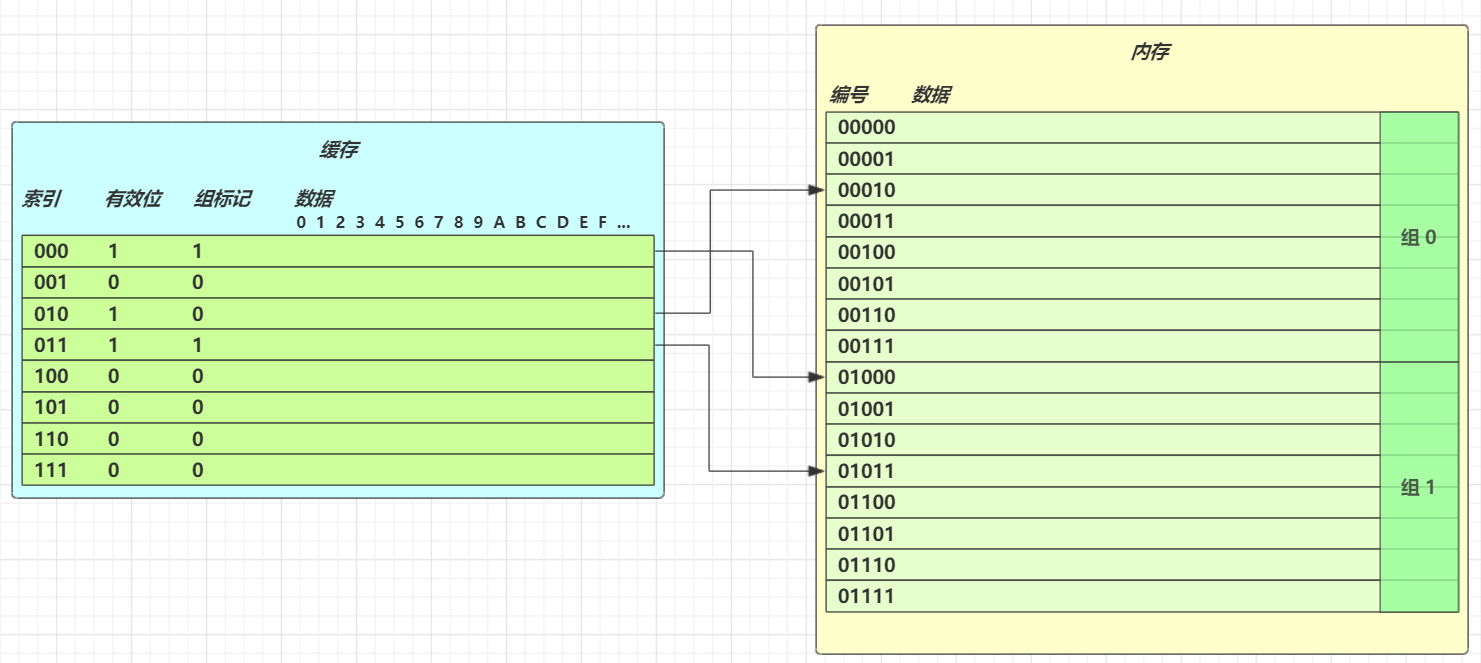
读取数据的流程如下:
- 根据低位索引,计算数据在缓存中的位置
- 查看有效位:
- 为 0:缓存无效,去内存读取新数据更新缓存行
- 为 1:再对比高位组标记是否一致
- 组标记一致:缓存命中,根据偏移量从缓存行中返回数据
- 组标记不一致:缓存未命中,去内存读取新数据更新缓存行
CPU 缓存一致性:MESI 协议
多核架构下,每个核心都有自己私有的 L1/L2 缓存。同一个变量在多个核心的缓存中各有一份副本,某个核心修改数据后,其他核心怎么知道自己的副本过期了?这就是缓存一致性问题:
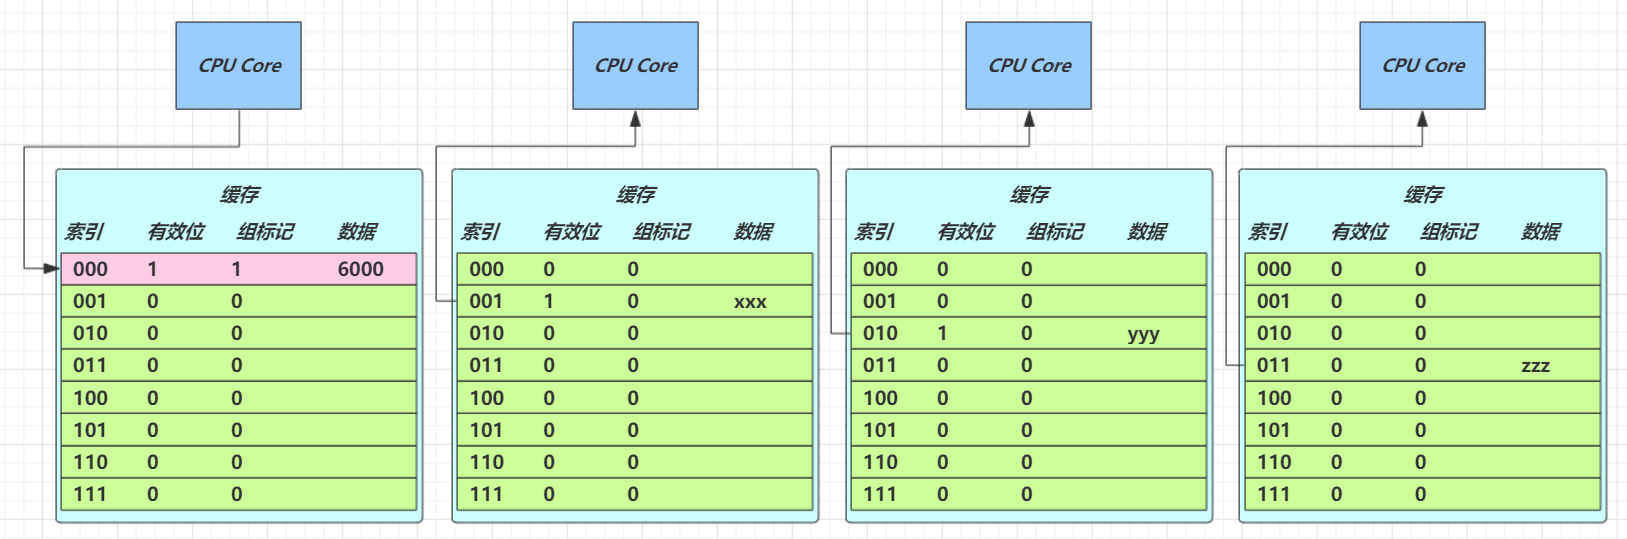
MESI 协议是解决该问题的经典方案,它为每个缓存行定义了四种状态,名字来自四个状态的首字母:
| 状态 | 全称 | 含义 |
|---|---|---|
| M | Modified(修改) | 缓存行数据已被本核心修改,与主存不一致,数据只在本核心缓存中 |
| E | Exclusive(独占) | 数据与主存一致,且只在本核心缓存中存在 |
| S | Shared(共享) | 数据与主存一致,且在多个核心缓存中存在 |
| I | Invalid(失效) | 缓存行无效,不能使用 |
MESI 的状态维护依赖总线嗅探(Bus Snooping):每个核心都在监听总线上与自己缓存行相关的读写事务,据此调整状态:
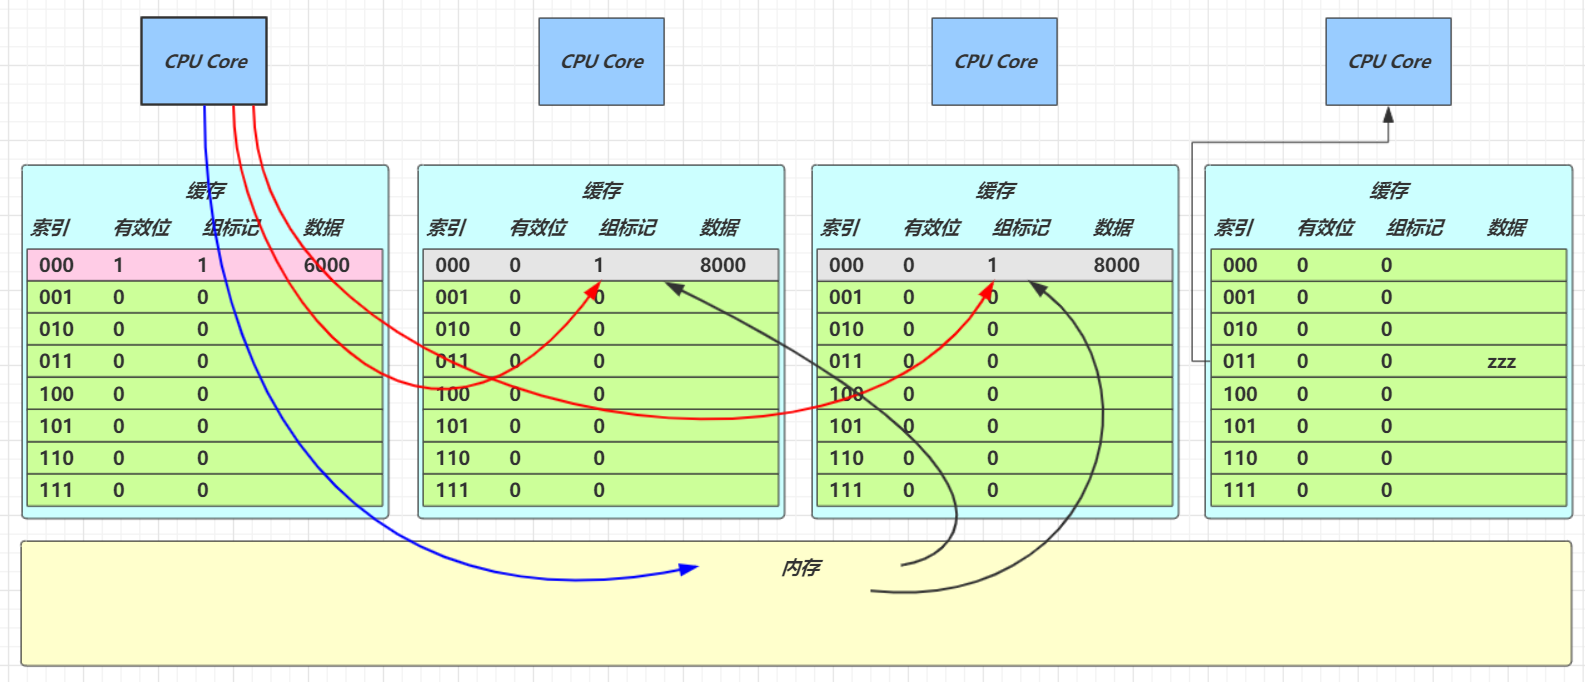
完整的状态流转规则可以归纳为:
- E、S、M 状态的缓存行都可以满足 CPU 的读请求
- E 状态的缓存行收到写请求,会将状态改为 M,这时并不立即触发向主存的写
- E 状态的缓存行必须嗅探该缓存行的读操作,一旦别的核心也要读,自己变为 S 状态
- M 状态的缓存行必须嗅探该缓存行的读操作:别的核心要读时,先把其它缓存中的副本(S 状态)置为 I,把数据写回主存,自己再变为 S 状态
- S 状态的缓存行收到写请求,走流程 4(广播失效 → 写回主存 → 转 S/M)
- S 状态的缓存行必须嗅探该缓存行的失效操作,一旦别的核心要独占写入,自己变为 I 状态
- I 状态的缓存行收到读请求,必须从主存重新读取
可以用一张状态转移表来概括:
| 当前状态 | 本地读 | 本地写 | 总线收到其他核读 | 总线收到其他核写/失效 |
|---|---|---|---|---|
| M | 保持 M | 保持 M | 写回主存 → S | 写回主存 → I |
| E | 保持 E | → M | → S | → I |
| S | 保持 S | 广播失效 → M | 保持 S | → I |
| I | 从主存读 → S/E | 读+独占写 → M | 无 | 无 |
MESI 保证了缓存副本之间最终一致,但状态同步通过总线消息完成,本身有开销。比 MESI 更需要 Java 程序员理解的,是软件层面用来约束缓存与重排序的机制——内存屏障。
内存屏障
内存屏障(Memory Barrier,又称内存栅栏 Memory Fence)是一类同时作用于编译器与 CPU 的同步指令,它把对共享变量的读写操作在屏障两侧"隔开",从而保证可见性与有序性。
JMM 把内存屏障抽象为四类:
| 屏障类型 | 指令形式 | 保证 |
|---|---|---|
| LoadLoad | Load1;LoadLoad;Load2 | Load1 的读先于 Load2 及之后所有的读完成 |
| StoreStore | Store1;StoreStore;Store2 | Store1 的写先于 Store2 及之后所有的写刷新到内存 |
| LoadStore | Load1;LoadStore;Store2 | Load1 的读先于 Store2 及之后所有的写 |
| StoreLoad | Store1;StoreLoad;Load2 | Store1 的写对其他处理器可见后,Load2 及之后的读写才能执行;开销最大、功能最强 |
在 x86/x64 硬件上,大致对应三条 fence 指令:
- lfence(load fence,读屏障):强制从主存(或经缓存一致性协议)重新加载数据
- sfence(store fence,写屏障):强制把屏障之前的写缓冲刷新到缓存/主存
- mfence(memory fence,全屏障):兼具读写屏障能力
此外,x86 上带 lock 前缀的指令(如 lock add)在原子操作的同时会刷新写缓冲并产生总线锁定效果,是实现 StoreLoad 屏障最常见的手段。
volatile 原理
volatile 的底层实现原理就是内存屏障:
- 对 volatile 变量的写指令之后会加入写屏障
- 对 volatile 变量的读指令之前会加入读屏障
volatile 如何保证可见性
写屏障(sfence)保证在该屏障之前的、对共享变量的所有改动,都会同步到主存;读屏障(lfence)保证在该屏障之后对共享变量的读取,加载的是主存中的最新数据。
// 线程 t2
public void actor2(I_Result r) {
    num = 2;
    ready = true; // ready 是 volatile,赋值带写屏障
    // 写屏障:num = 2 也会在此之前一起刷新到主存
}

// 线程 t1
public void actor1(I_Result r) {
    // 读屏障:之后的读取都从主存加载最新值
    if (ready) {          // ready 是 volatile,读取带读屏障
        r.r1 = num + num; // 因此这里一定能看到 num = 2
    } else {
        r.r1 = 1;
    }
}
执行时序是:t2 写 ready = true 时的写屏障把 num = 2 一并刷入主存;t1 读 ready 时的读屏障让它从主存读到 true,随后读取 num 也必然是 2,不会再读到自己缓存中的旧值 0。
volatile 如何保证有序性
屏障同时约束编译器和 CPU 的重排序行为:
- 写屏障确保指令重排序时,不会把写屏障之前的代码排到写屏障之后
- 读屏障确保指令重排序时,不会把读屏障之后的代码排到读屏障之前
上例中:
- 写屏障保证 t2 中
num = 2不会被排到ready = true之后 - 读屏障保证 t1 中对
num的读取不会被排到读ready之前
这样 t1 一旦看到 ready == true,就一定能看到 t2 在写屏障之前的所有修改。
但要强调的是,volatile 不能解决指令交错:
- 写屏障仅仅保证"之后的读能读到最新结果",并不能让对方线程的读主动跑到前面来
- 有序性保证的范围仅限于本线程内相关代码不被重排序,跨线程的执行先后仍需互斥同步来控制
volatile 不保证原子性
可见性与原子性是两个独立的问题。volatile int i 的自增在字节码层面仍是"读—改—写"三步:
getstatic i   // 读取 i
iconst_1
iadd          // +1
putstatic i   // 写回 i
两个线程同时读到 0,分别 +1、-1 后各自写回,结果就可能是 1 或 -1,而不是期望的 0。volatile 只保证 t1 写回的值对 t2 可见,却不能保证读改写三步不被其他线程插入。因此计数场景仍需 synchronized、AtomicInteger 或 CAS。
经典案例:double-checked locking 问题
著名的双重检查锁定单例,乍看既懒惰初始化又高效:
public final class Singleton {
    private Singleton() { }
    private static Singleton INSTANCE = null;

    public static Singleton getInstance() {
        if (INSTANCE == null) { // t2:第一个 if 在同步块之外
            synchronized (Singleton.class) {
                if (INSTANCE == null) { // t1
                    INSTANCE = new Singleton();
                }
            }
        }
        return INSTANCE;
    }
}
getInstance 方法对应的关键字节码为:
17: new            #3   // 创建对象,将对象引用入栈
20: dup                // 复制一份对象引用
21: invokespecial  #4   // 调用构造方法 <init>
24: putstatic      #2   // 赋值给静态变量 INSTANCE
问题在于:JVM 可能把 24 重排到 21 之前(先发布引用,后执行构造)。关键在于外层 0: getstatic 位于 monitor 控制之外,它可以越过 monitor 读取 INSTANCE 的值:
- t1 执行
17: new、20: dup、24: putstatic,INSTANCE 已经非空,但21: invokespecial构造方法尚未执行 - t2 执行
0: getstatic发现 INSTANCE 不为空,直接areturn返回并使用对象 - t2 拿到的是一个尚未初始化完毕的单例,构造方法中大量的初始化操作还没做
对 INSTANCE 使用 volatile 修饰即可禁用该重排(注意:JDK 5 及以上版本的 volatile 才真正提供这一语义):
public final class Singleton {
    private Singleton() { }
    private static volatile Singleton INSTANCE = null;

    public static Singleton getInstance() {
        if (INSTANCE == null) {
            synchronized (Singleton.class) {
                if (INSTANCE == null) {
                    INSTANCE = new Singleton();
                }
            }
        }
        return INSTANCE;
    }
}
在字节码层面看不出 volatile 指令的效果,但屏障位置如下:
 0: getstatic     #2   // Field INSTANCE
// ------------------> 对 INSTANCE 的读屏障
 3: ifnonnull     37
 ...
10: monitorenter       // 保证原子性、可见性
 ...
17: new           #3
20: dup
21: invokespecial #4   // 调用构造方法
24: putstatic     #2   // 赋值 INSTANCE
// ------------------> 对 INSTANCE 的写屏障:保证 21 先于 24 对外可见
27: aload_0
28: monitorexit        // 保证原子性、可见性
 ...
37: getstatic     #2
40: areturn
从更底层看,读写 volatile 变量时使用 lock 前缀指令来保证多核 CPU 之间的可见性与有序性。
final 原理
理解了 volatile,再对比 final 的实现就比较简单了。
设置 final 变量的原理
public class TestFinal {
    final int a = 20;
}
其构造方法的字节码为:
0: aload_0
1: invokespecial #1   // Method java/lang/Object."<init>":()V
4: aload_0
5: bipush        20
7: putfield      #2   // Field a:I
    <-- 写屏障
10: return
final 变量的赋值同样通过 putfield 指令完成,在这条指令之后也会插入写屏障,保证该字段在构造函数返回前就被正确发布——其他线程拿到对象引用时,不会看到 final 字段还是默认值 0。这正是不可变对象(如 String)无需同步即可安全共享的硬件基础。
获取 final 变量的原理
对称地,读取 final 字段时,JMM 要求在读对象引用与读 final 字段之间插入读屏障,确保线程拿到对象引用后,看到的一定是构造期写屏障刷新出来的 final 值,而不是构造过程中的中间状态。
一句话总结:volatile 通过"写后刷、读前取"的屏障保证共享变量的可见与有序;final 通过构造期写屏障保证对象的安全发布。 它们都不保证复合操作的原子性——而保证原子性的重量级武器 synchronized 与 Monitor,将在下一篇剖析。