
12synchronized与Monitor底层原理
应用篇中我们已经会用 synchronized 保护临界区、用 wait/notify 与 LockSupport 做线程间等待唤醒。本篇是原理篇,要回答几个底层问题:synchronized 锁住的到底是什么?锁对象的对象头里发生了什么?无竞争时为什么几乎没有性能损耗?wait/notify 与 park/unpark 又是如何把线程挂起和唤醒的?
Monitor 概念
Monitor 被翻译为监视器或管程,它是一种保证同一时刻只有一个线程进入临界区、并能管理等待队列的同步机制。
每个 Java 对象都可以关联一个 Monitor 对象。当使用 synchronized 给对象上锁(重量级锁)之后,该对象头的 Mark Word 中就被设置为指向 Monitor 对象的指针。Monitor 的结构如下:
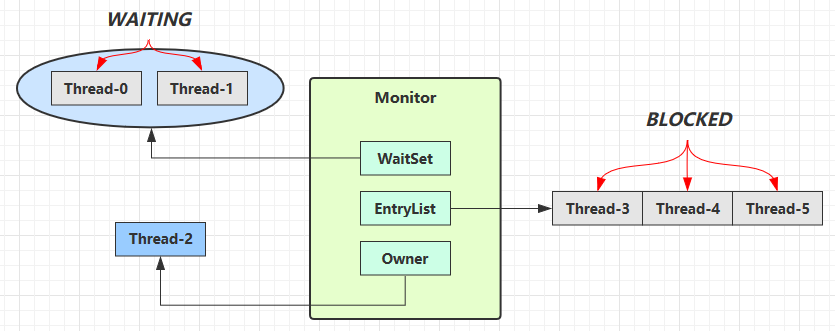
工作过程:
- 刚开始 Monitor 中 Owner 为 null
- 当 Thread-2 执行
synchronized(obj),将 Monitor 的所有者 Owner 置为 Thread-2,Monitor 中只能有一个 Owner - Thread-2 上锁过程中,如果 Thread-3、Thread-4、Thread-5 也来执行
synchronized(obj),就会进入 EntryList,状态为 BLOCKED - Thread-2 执行完同步代码块后,唤醒 EntryList 中等待的线程竞争锁,竞争时是非公平的
- 图中 WaitSet 里的 Thread-0、Thread-1,是之前获得过锁、但条件不满足而调用
wait()进入 WAITING 状态的线程
注意:
- synchronized 必须是进入同一个对象的 monitor 才有上述效果
- 不加 synchronized 的对象不会关联监视器,不遵从以上规则
HotSpot 中的 ObjectMonitor
在 HotSpot 虚拟机中,Monitor 的实现类是 ObjectMonitor(位于 objectMonitor.hpp),其关键字段可以简化表示为:
class ObjectMonitor {
    // 对象头 Mark Word 的备份
    volatile markWord   _header;
    // 关联的 Java 对象
    void*               _object;
    // 持有锁的线程(Owner),不持锁时为 NULL
    void* volatile      _owner;
    // 等待队列:调用 wait() 的线程挂在这里,ObjectWaiter 组成的双向循环链表
    ObjectWaiter* volatile _WaitSet;
    // 阻塞队列:竞争锁失败的线程挂在这里
    ObjectWaiter* volatile _EntryList;
    // wait() 等待线程数
    volatile jlong      _waiters;
    // 重入次数:同一线程可重入,_recursions 记录深度
    volatile jlong      _recursions;
    // 竞争计数
    volatile jlong      _count;
};它底层依赖操作系统提供的互斥量(Mutex Lock) 与条件变量(Condition Variable):互斥量保证 Owner 唯一,条件变量负责把 EntryList/WaitSet 中的线程挂起与唤醒。线程的 BLOCKED/WAITING 都是真正让出 CPU 时间片的阻塞,由操作系统调度唤醒。
synchronized 的字节码原理
看一段最普通的同步代码:
static final Object lock = new Object();
static int counter = 0;

public static void main(String[] args) {
    synchronized (lock) {
        counter++;
    }
}
对应的关键字节码为:
 0: getstatic     #2   // <- lock 引用(synchronized 开始)
 3: dup
 4: astore_1           // lock 引用 -> slot 1
 5: monitorenter       // 将 lock 对象 Mark Word 置为 Monitor 指针
 6: getstatic     #3   // <- i
 9: iconst_1           // 准备常数 1
10: iadd               // +1
11: putstatic     #3   // -> i
14: aload_1            // <- lock 引用
15: monitorexit        // 将 Mark Word 重置,唤醒 EntryList
16: goto          24
19: astore_2           // 异常路径
20: aload_1
21: monitorexit        // 异常时也要释放锁
22: aload_2
23: athrow
24: return- monitorenter:尝试获取对象的 Monitor,成功后成为 Owner;对应进入同步块
- monitorexit:释放 Monitor,把 Owner 置空,并唤醒 EntryList 中的阻塞线程
注意字节码中有两个 monitorexit:正常退出路径一个,异常表(Exception table)保证异常抛出路径一个,确保锁一定被释放。
注意:方法级别的 synchronized 不会在字节码指令中体现,它是在方法的访问标志中加上
ACC_SYNCHRONIZED,JVM 调用方法时隐式完成加锁解锁。
synchronized 原理进阶
重量级锁直接走操作系统互斥量,挂起/唤醒线程需要在用户态与内核态之间切换,开销很大。事实上 synchronized 在无竞争或轻竞争场景下,会优先使用偏向锁、轻量级锁等用户态优化,只有迫不得已才膨胀为重量级锁。
轻量级锁
轻量级锁的使用场景:一个对象虽然有多个线程要加锁,但加锁时间是错开的(也就是没有实际竞争),这时用轻量级锁优化。轻量级锁对使用者是透明的,语法仍然是 synchronized。
加锁:Lock Record 与 CAS
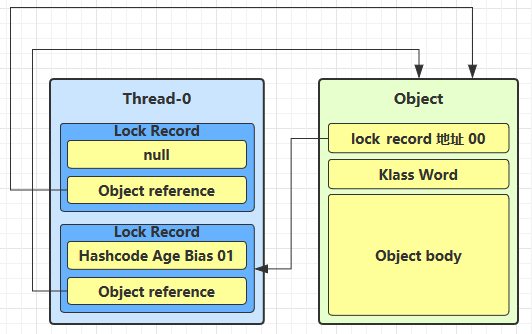
每个线程的栈帧中都包含一个锁记录(Lock Record) 结构,内部可以存储锁定对象的 Mark Word。加锁前:
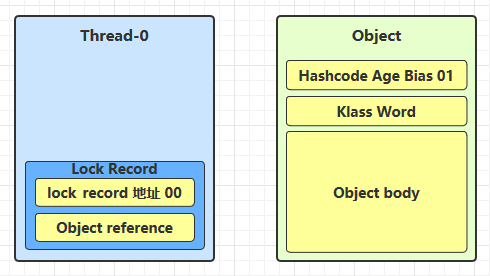
加锁过程:
- 在当前栈帧中创建锁记录,每个线程都会包含一个锁记录结构
- 让锁记录中的 Object reference 指向锁对象
- 尝试用 CAS 把对象的 Mark Word 替换到锁记录中(即交换两者内容)
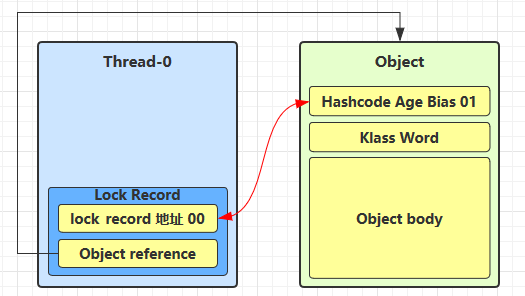
如果 CAS 替换成功,对象头中存储了锁记录地址和状态位 00,表示由该线程给对象加上了轻量级锁:
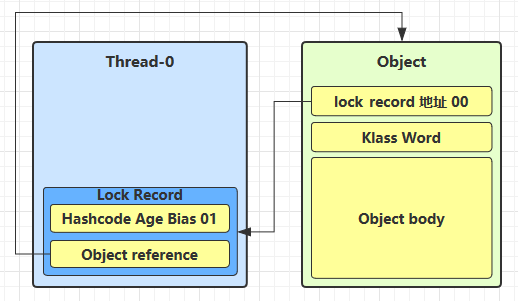
如果 CAS 失败,有两种情况:
- 其它线程已经持有了该对象的轻量级锁:表明有竞争,进入锁膨胀过程
- 自己执行了 synchronized 锁重入:再添加一条 Lock Record 作为重入计数。重入时新增锁记录保存的 Mark Word 值为 null:
解锁
退出 synchronized 代码块时:
- 如果有取值为 null 的锁记录,表示这次退出的是重入层,重置该锁记录,表示重入计数减一
- 如果锁记录的值不为 null,使用 CAS 将保存的 Mark Word 恢复给对象头:
- 成功:解锁成功
- 失败:说明轻量级锁已经进行了锁膨胀、升级为重量级锁,进入重量级锁的解锁流程
锁膨胀
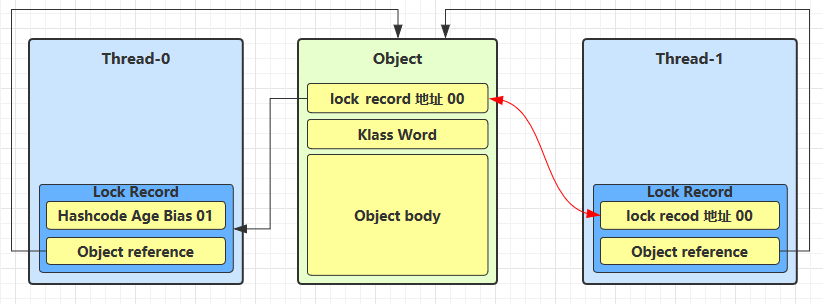
如果在尝试加轻量级锁时 CAS 无法成功,且原因是其它线程已经为对象加上了轻量级锁(有竞争),就需要进行锁膨胀,将轻量级锁变为重量级锁。
当 Thread-1 进行轻量级加锁时,Thread-0 已经持有该对象的轻量级锁,Thread-1 的 CAS 失败:
这时 Thread-1 进入锁膨胀流程:
- 为 Object 对象申请 Monitor 锁,让 Object 的 Mark Word 指向重量级锁地址(状态位 10)
- 自己进入 Monitor 的 EntryList,变为 BLOCKED
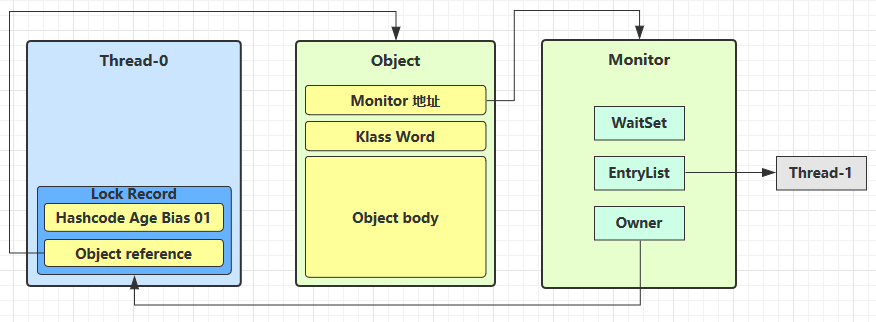
当 Thread-0 退出同步块解锁时,用 CAS 把 Mark Word 恢复给对象头会失败(对象头已经是 Monitor 地址)。于是进入重量级解锁流程:按 Monitor 地址找到 Monitor 对象,把 Owner 设为 null,唤醒 EntryList 中的 BLOCKED 线程。
完整的锁升级路径是:
无锁(01) ──首次CAS──> 轻量级锁(00) ──出现竞争──> 重量级锁(10)
  ↑ 开启偏向后实际为:
偏向锁(101) ──其他线程竞争──> 轻量级锁(00) ──竞争加剧──> 重量级锁(10)
锁只能升级、不能降级(GC 过程除外)。
自旋优化
重量级锁竞争时,还可以使用自旋优化:当前线程竞争失败后不急着挂起,而是循环重试几次 CAS。如果自旋期间持锁线程已经退出同步块释放了锁,当前线程就能直接拿到锁,避免一次昂贵的线程阻塞。
- 自旋重试成功:持锁线程很快执行完毕,自旋线程获得锁
- 自旋重试失败:超过自旋次数仍未获得锁,才真正进入阻塞
自旋的特点:
- 自旋会占用 CPU 时间,单核 CPU 自旋纯属浪费(持锁线程都没机会执行),多核 CPU 自旋才能发挥优势
- Java 6 之后自旋是自适应的:如果该对象上一次自旋成功过,JVM 认为这次成功概率高,就多自旋几次;反之就少自旋甚至不自旋
- Java 7 之后无法通过参数手动控制自旋的开关
偏向锁
轻量级锁在没有竞争时(只有自己这个线程),每次重入仍然需要执行 CAS。Java 6 引入了偏向锁进一步优化:只有第一次使用 CAS 将线程 ID 设置到对象的 Mark Word,之后发现这个线程 ID 是自己的,就表示没有竞争,不用再做任何 CAS。以后只要不发生竞争,这个对象就归该线程所有。
例如同一线程在 m1 → m2 → m3 的嵌套调用中反复对同一对象加锁:轻量级锁每次都要生成锁记录并 CAS,而偏向锁只需比较 Thread ID。
对象头 Mark Word 的位布局
64 位 JVM 中对象头 Mark Word 的布局如下(可借助 JOL 工具查看):
|                          Mark Word (64 bits)                         |       State        |
|---------------------------------------------------------------------|--------------------|
| unused:25 | hashcode:31 | unused:1 | age:4 | biased_lock:0 | 锁:01   |       Normal       |
|---------------------------------------------------------------------|--------------------|
| thread:54 | epoch:2     | unused:1 | age:4 | biased_lock:1 | 锁:01   |       Biased       |
|---------------------------------------------------------------------|--------------------|
|             ptr_to_lock_record:62                            | 锁:00  | Lightweight Locked |
|---------------------------------------------------------------------|--------------------|
|             ptr_to_heavyweight_monitor:62                    | 锁:10  | Heavyweight Locked |
|---------------------------------------------------------------------|--------------------|
|                                                             | 锁:11   |    Marked for GC   |
|---------------------------------------------------------------------|--------------------|
一个对象创建时:
- 如果开启了偏向锁(JDK 8 默认开启),对象创建后 Mark Word 值为
0x05,即最后 3 位为101,此时 thread、epoch、age 都为 0 - 偏向锁默认是延迟的,不会在程序启动时立即生效(避免与启动期大量的锁操作冲突)。想避免延迟可加 VM 参数
-XX:BiasedLockingStartupDelay=0 - 如果没有开启偏向锁,Mark Word 值为
0x01,即最后 3 位为001,hashcode、age 都为 0,第一次用到 hashcode 时才赋值
偏向状态的输出特征:
synchronized 前:... 00000101   // 匿名偏向
synchronized 中:... 00000101   // 高位写入线程 ID,末三位仍为 101
synchronized 后:... 00000101   // 解锁后线程 ID 仍留在对象头中
即处于偏向锁的对象解锁后,线程 ID 仍存储于对象头,这正是"偏向"的含义。
偏向锁的撤销
以下情况会使偏向锁被撤销或升级:
- 调用对象的 hashCode:偏向状态的 Mark Word 没有地方存放 31 位 hashcode(位置被线程 ID 占了),调用 hashCode 会导致偏向锁被撤销。轻量级锁会在锁记录中记录 hashCode,重量级锁会在 Monitor 中记录
- 其它线程使用对象:当有其它线程来使用这个偏向对象时,偏向锁会被撤销并升级为轻量级锁;若同时存在竞争,则继续膨胀为重量级锁
- 调用 wait/notify:wait/notify 只有重量级锁才支持,一旦调用就直接膨胀为重量级锁
批量重偏向
如果对象虽然被多个线程访问,但没有竞争,这时偏向了 T1 的对象仍有机会重新偏向 T2,重偏向会重置对象的 Thread ID。
当撤销偏向锁的阈值超过 20 次后,JVM 会觉得"我是不是偏向错了",于是在给这些对象加锁时会重新偏向至当前加锁线程,而不必逐个撤销走轻量级锁。
批量撤销
当撤销偏向锁阈值超过 40 次后,JVM 会认为自己确实偏向错了,根本就不该偏向。于是整个类的所有对象都会变为不可偏向的,之后新建的对象也是不可偏向的。
补充:偏向锁在 JDK 15(JEP 374)中被废弃并默认禁用。现代 JDK 下 synchronized 默认直接走轻量级锁流程,但其加锁逻辑、Mark Word 布局与锁膨胀机制仍然是理解一切锁的基础。
锁消除
JIT 编译器的逃逸分析如果发现某个锁对象是方法内的局部对象、不可能逃逸出方法被其他线程共享,就会把 synchronized 自动消除掉。
用 JMH 做基准测试:
@Fork(1)
@BenchmarkMode(Mode.AverageTime)
@Warmup(iterations = 3)
@Measurement(iterations = 5)
@OutputTimeUnit(TimeUnit.NANOSECONDS)
public class MyBenchmark {
    static int x = 0;

    @Benchmark
    public void a() {
        x++;
    }

    @Benchmark
    public void b() {
        Object o = new Object(); // 局部对象,不逃逸
        synchronized (o) {
            x++;
        }
    }
}
默认开启锁消除时,两者性能几乎没有差别:
Benchmark            Mode  Samples  Score   Score error  Units
c.i.MyBenchmark.a    avgt        5  1.542         0.056  ns/op
c.i.MyBenchmark.b    avgt        5  1.518         0.091  ns/op
加上 -XX:-EliminateLocks 关闭锁消除后,b 方法的锁开销立刻显现:
Benchmark            Mode  Samples   Score  Score error  Units
c.i.MyBenchmark.a    avgt        5   1.507         0.108  ns/op
c.i.MyBenchmark.b    avgt        5  16.976         1.572  ns/op
锁粗化
对同一个对象反复加锁解锁(例如在循环体内 synchronized),会导致线程频繁重入。JIT 会把相邻的加锁操作合并,把锁的范围粗化到整个操作序列的外部,用一次加解锁代替多次。注意这与"细分锁粒度提高并行度"是相反方向的优化,二者由 JIT 根据场景取舍。
wait/notify 原理
wait/notify 的行为全部围绕 Monitor 展开:
- Owner 线程发现条件不满足,调用
wait()方法,即进入 WaitSet,状态变为 WAITING - BLOCKED 和 WAITING 的线程都处于阻塞状态,不占用 CPU 时间片
- BLOCKED 线程会在 Owner 线程释放锁时被唤醒
- WAITING 线程会在 Owner 线程调用
notify()或notifyAll()时被唤醒,但唤醒并不意味着立刻获得锁,仍需进入 EntryList 重新竞争
底层对应 ObjectMonitor 中的机制:
wait()本质上是先释放 Monitor(Owner 置空、重入计数归零),再把当前线程封装成 ObjectWaiter 挂入_WaitSet,在底层条件变量上阻塞notify()从_WaitSet取下一个节点(notifyAll取全部)移到_EntryList,等待重新竞争_waiters/_count等字段记录等待线程数与竞争情况,供 Monitor 做唤醒决策
join 的原理
Thread.join() 本质上是调用者线程在被等待线程对象上 wait,并轮询其存活状态。如下代码与 join 的实现等价:
synchronized (t1) {
    // 调用者线程进入 t1 的 waitSet 等待,直到 t1 运行结束
    while (t1.isAlive()) {
        t1.wait(0);
    }
}
t1 线程运行结束时,JVM 会自动在 t1 对象上做一次 notifyAll,唤醒所有 join 等待者。join 体现的是【保护性暂停】模式。
park/unpark 原理
LockSupport.park() 与 unpark() 是 AQS 等 JUC 同步器的基础,它们不依赖 synchronized,也不需要获取对象锁。
每个线程都关联一个 Parker 对象,由三部分组成:_counter、_cond 和 _mutex。HotSpot 中的简化定义如下:
class Parker : public os::PlatformParker {
    // 许可计数:只有 0 和 1 两个取值
    volatile int _counter;
    // 互斥量,保护 _counter 的并发修改
    os::PlatformMutex _mutex;
    // 条件变量,线程 park 时在此阻塞
    os::PlatformCondition _cond;
};
打个比喻:
- 线程是一个旅人,Parker 是他随身携带的背包
- 条件变量
_cond好比背包里的帐篷 _counter好比背包里的备用干粮(0 为耗尽,1 为充足)
语义:
- 调用 park 就是看需不需要停下来歇息:干粮耗尽(
_counter == 0),就钻进帐篷歇息;干粮充足(_counter == 1),则不做停留,消耗干粮后继续前进 - 调用 unpark 就好比令干粮充足:如果线程还在帐篷里,就唤醒它继续前进;如果线程还在运行,下次它调用 park 时只会消耗掉备用干粮,不阻塞
- 背包空间有限,多次调用 unpark 只会补充一份干粮(许可不会累加)
park 的执行过程
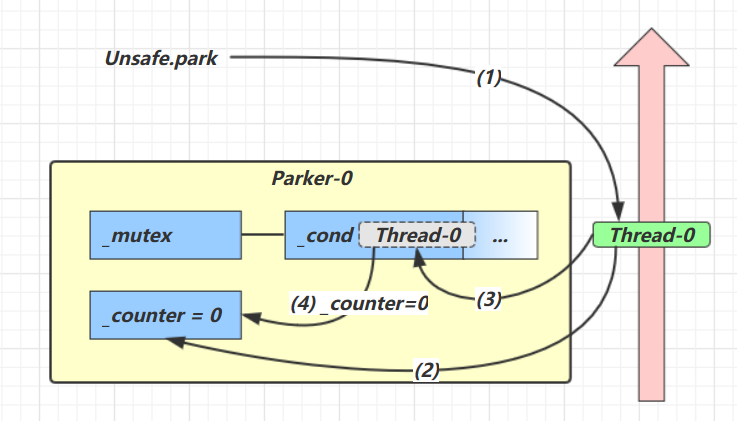
当前线程调用 Unsafe.park():
- 检查
_counter,本情况为 0,这时获取_mutex互斥锁 - 线程进入
_cond条件变量阻塞 - (被唤醒后)线程恢复运行
- 设置
_counter = 0
unpark 的执行过程
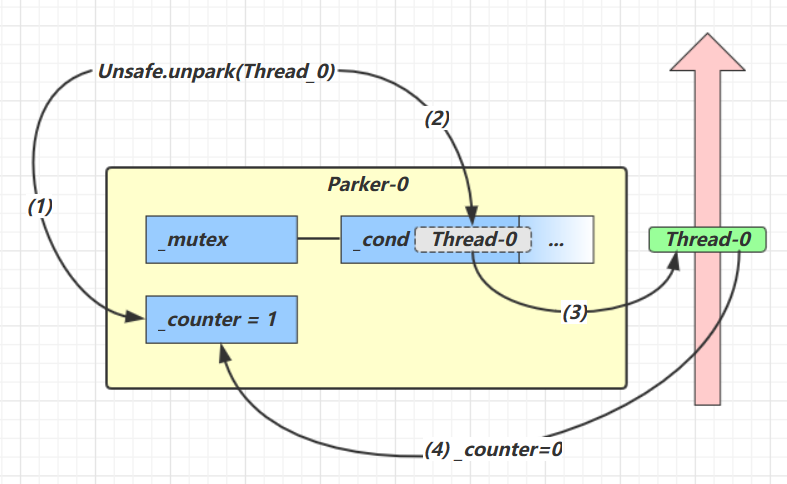
调用 Unsafe.unpark(Thread_0):
- 设置
_counter为 1 - 唤醒
_cond条件变量中阻塞的 Thread-0 - Thread-0 恢复运行
- 设置
_counter = 0
为什么"先 unpark 后 park"不会阻塞
这是 park/unpark 与 wait/notify 最关键的区别。如果执行顺序反过来:
- 先调用
Unsafe.unpark(Thread_0),设置_counter为 1 - 当前线程随后调用
Unsafe.park() - 检查
_counter,本情况为 1,这时线程无需阻塞,继续运行 - 设置
_counter= 0
因为 unpark 发放的"许可"由 _counter 记录、可以暂存,所以唤醒先于等待发生时不会丢失信号。这也是 JUC 同步器偏爱 park/unpark 的原因:
| 对比项 | wait/notify | park/unpark |
|---|---|---|
| 前提 | 必须先获得对象锁(synchronized) | 不需要锁 |
| 唤醒顺序 | notify 必须在 wait 之后,否则信号丢失 | 可先 unpark 后 park,许可暂存在 _counter |
| 唤醒目标 | 随机/全部,无法精确指定 | unpark 可精确唤醒指定线程 |
| 许可累积 | 无 | 最多暂存 1 个,不累积 |
至此,synchronized 从偏向锁、轻量级锁到重量级锁的完整升级链条,以及对象监视器与线程阻塞唤醒的两套底层机制(Monitor 条件变量、Parker 许可计数)就全部串通了。