
14并发容器底层原理
使用篇我们见过 ConcurrentHashMap 和各种阻塞队列,本篇深入底层:先在 JDK 7 下复现经典的 HashMap 并发扩容死链问题,搞清楚非线程安全容器在并发下到底会坏成什么样;然后对照学习 JDK 8 ConcurrentHashMap 的 sizeCtl、分桶计数、CAS + synchronized 锁桶、协助扩容与无锁 get;最后剖析 LinkedBlockingQueue 用两把锁实现生产者/消费者并行的巧妙设计。
JDK 7 HashMap 并发死链
问题背景
JDK 7 的 HashMap 在多线程下并发扩容,可能产生环形链表(死链)。此后对该桶执行 get 就会陷入死循环,CPU 飙升。要复现它必须在 JDK 7 下运行——JDK 8 调整了扩容算法(尾插 + 高低位拆分),hash 计算方法也变了。
精心准备的测试代码
死链不是随便 put 就能触发的,需要精心挑选落在同一个桶、扩容后又发生桶位置变化的 key。下面的测试先打印哪些整数在容量 16 和 32 时落在 1 号桶:
public static void main(String[] args) {
    // 看看 JDK 7 中哪些数字的 hash 结果相等
    System.out.println("长度为16时,桶下标为1的key");
    for (int i = 0; i < 64; i++) {
        if (hash(i) % 16 == 1) {
            System.out.println(i);
        }
    }
    System.out.println("长度为32时,桶下标为1的key");
    for (int i = 0; i < 64; i++) {
        if (hash(i) % 32 == 1) {
            System.out.println(i);
        }
    }
    // 1、35、16、50 当大小为 16 时, 它们在同一个桶内
    final HashMap<Integer, Integer> map = new HashMap<Integer, Integer>();
    // 先放 12 个元素(默认容量 16, 阈值 12)
    map.put(2, null);
    map.put(3, null);
    map.put(4, null);
    map.put(5, null);
    map.put(6, null);
    map.put(7, null);
    map.put(8, null);
    map.put(9, null);
    map.put(10, null);
    map.put(16, null);
    map.put(35, null);
    map.put(1, null);

    System.out.println("扩容前大小[main]:" + map.size());
    new Thread() {
        @Override
        public void run() {
            // 放第 13 个元素, 触发扩容 16 -> 32
            map.put(50, null);
            System.out.println("扩容后大小[Thread-0]:" + map.size());
        }
    }.start();
    new Thread() {
        @Override
        public void run() {
            // 同样放第 13 个元素, 同样触发扩容
            map.put(50, null);
            System.out.println("扩容后大小[Thread-1]:" + map.size());
        }
    }.start();
}

// JDK 7 的 hash 扰动函数
final static int hash(Object k) {
    int h = 0;
    if (0 != h && k instanceof String) {
        return sun.misc.Hashing.stringHash32((String) k);
    }
    h ^= k.hashCode();
    h ^= (h >>> 20) ^ (h >>> 12);
    return h ^ (h >>> 7) ^ (h >>> 4);
}
输出中可以看到:容量 16 时 1、16、35、50 都落在 1 号桶;容量变成 32 后,16 和 50 迁到 17 号桶,而 1、35 仍在 1 号桶。
死链复现
调试时在 HashMap 源码 590 行(newTable 创建处)加条件断点,让两个线程扩容到 32 时都停下来,断点暂停方式选择 Thread(否则调试 Thread-0 时 Thread-1 无法恢复):
int newCapacity = newTable.length;
// 条件: newTable.length==32 &&
//       (Thread-0 或 Thread-1)
再在 593/594 行加线程条件断点,观察局部变量 e 和 next:
Entry<K,V> next = e.next; // 593
if (rehash) {            // 594
初始时 1 号桶的链表为 (1)->(35)->(16)->null,Thread-0 停在 594 行时:
e    = (1)->(35)->(16)->null
next = (35)->(16)->null
此时在 Threads 面板让 Thread-1 先跑完扩容。由于头插法会把后处理的节点放到链表头,Thread-1 扩容完成后链表顺序被倒过来:
newTable[1] = (35)->(1)->null
扩容后大小:13
这时 Thread-0 还停在 594 行,但它栈里的局部变量引用没变、对象内容已经被 Thread-1 改了:
e    = (1)->null
next = (35)->(1)->null
让 Thread-0 继续单步:
- 第一轮:把 e=(1) 头插到新桶,
newTable[1] = (1)->null,e 推进到 (35),而此时next = (1)->null; - 第二轮:把 e=(35) 头插,
newTable[1] = (35)->(1)->null,e 推进到 (1),next 为 null; - 第三轮:e=(1)、next=null,但执行头插语句
e.next = newTable[1]时,newTable[1] 的头正是 (35),而 (35).next 又指向 (1) 自己——1 和 35 互相指向,死链形成。
罪魁祸首:transfer 头插法
JDK 7 扩容迁移的核心方法 transfer,注意"2 处"的两句头插:
void transfer(Entry[] newTable, boolean rehash) {
    int newCapacity = newTable.length;
    for (Entry<K,V> e : table) {
        while (null != e) {
            Entry<K,V> next = e.next;   // 先记下后继
            // 1 处
            if (rehash) {
                e.hash = null == e.key ? 0 : hash(e.key);
            }
            int i = indexFor(e.hash, newCapacity);
            // 2 处: 头插法 —— 新元素的 next 指向原桶头, 再把桶头换成自己
            e.next = newTable[i];
            newTable[i] = e;
            e = next;
        }
    }
}
把整个过程按线程切换重新梳理一遍(链表格式 [下标] (key, next)):
原始链表:
[1] (1,35)->(35,16)->(16,null)
线程 a 执行到 1 处挂起:局部变量 e=(1,35)、next=(35,16)。线程 b 完整跑完三轮头插:
线程 b 第一次循环:  [1] (1,null)
线程 b 第二次循环:  [1] (35,1)->(1,null)
线程 b 第三次循环:  [1] (35,1)->(1,null)   [17] (16,null)
切回线程 a,e 和 next 被恢复,引用没变但对象内容已变:e 的内容是 (1,null),next 的内容是 (35)->(1,null):
线程 a 第一次循环:  [1] (1,null)
线程 a 第二次循环:  [1] (35,1)->(1,null)   // e=(35,1), 它的 next 又是 (1)
线程 a 第三次循环:
    e=(1,null), next=null
    执行 e.next = newTable[1];
    -> (1).next 指向 (35), 而 (35).next 本来就指向 (1)
[1] (1,35)->(35,1)->(1,35)   // 环形链表, 死链已成
虽然下一句 e = next(next 为 null)会结束这条链表的复制,但环形结构已经留在桶里,之后任何遍历到该桶的 get/put 都在 while (e != null) 中死循环。
小结
- 根因是在多线程环境下使用了非线程安全的 Map 集合;
- JDK 8 把扩容改为尾插 + 高低位两条链表,保持元素扩容前的相对顺序,环形链表不会再出现,但仍不意味着可以在多线程下使用——并发 put 还可能丢数据,并发场景必须使用 ConcurrentHashMap。
JDK 8 ConcurrentHashMap 原理
JDK 8 的 ConcurrentHashMap 不再使用分段锁,结构为 Node 数组 + 链表 / 红黑树,并发控制靠 CAS + synchronized(锁桶头节点)。下面数组简称 table,链表简称 bin。
重要属性和内部类
// 默认为 0
// 当初始化时, 为 -1
// 当扩容时, 为 -(1 + 扩容线程数)
// 当初始化或扩容完成后, 为下一次扩容的阈值大小
private transient volatile int sizeCtl;

// 整个 ConcurrentHashMap 就是一个 Node[]
static class Node<K,V> implements Map.Entry<K,V> {}

// hash 表
transient volatile Node<K,V>[] table;

// 扩容时的新 hash 表
private transient volatile Node<K,V>[] nextTable;

// 某个 bin 迁移完毕后, 用它作为旧 table 该 bin 的头节点(find 会转发到新表)
static final class ForwardingNode<K,V> extends Node<K,V> {}

// compute / computeIfAbsent 时占位, 计算完成后替换为普通 Node
static final class ReservationNode<K,V> extends Node<K,V> {}

// 树化 bin 的头节点, 存储 root 和 first
static final class TreeBin<K,V> extends Node<K,V> {}

// 红黑树节点, 存储 parent、left、right
static final class TreeNode<K,V> extends Node<K,V> {}
对数组元素的读写都绕过普通数组的非可见性,走 Unsafe 的 volatile 语义:
// 获取 table[i]
static final <K,V> Node<K,V> tabAt(Node<K,V>[] tab, int i);
// CAS 修改 table[i], c 为旧值, v 为新值
static final <K,V> boolean casTabAt(Node<K,V>[] tab, int i, Node<K,V> c, Node<K,V> v);
// 直接写入 table[i] (volatile 写)
static final <K,V> void setTabAt(Node<K,V>[] tab, int i, Node<K,V> v);
构造器:懒惰初始化
构造方法里并不创建 table,仅仅根据初始容量、负载因子计算一个 2^n 的数组大小记到 sizeCtl,第一次 put 时才真正建数组:
public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) {
    if (!(loadFactor > 0.0f) || initialCapacity < 0 || concurrencyLevel <= 0)
        throw new IllegalArgumentException();
    if (initialCapacity < concurrencyLevel)
        initialCapacity = concurrencyLevel;
    long size = (long)(1.0 + (long)initialCapacity / loadFactor);
    // tableSizeFor 保证容量是 2^n: 16、32、64 ...
    int cap = (size >= (long)MAXIMUM_CAPACITY) ?
        MAXIMUM_CAPACITY : tableSizeFor((int)size);
    this.sizeCtl = cap;
}
put 流程
整体规则:
- table 没初始化:CAS 初始化;
- 目标 bin 还没创建:CAS 放头节点,无锁;
- 目标 bin 的头是 ForwardingNode(hash == MOVED):说明正在扩容,当前线程先帮忙扩容再重试;
- 否则:synchronized 锁住桶头节点,链表尾插或红黑树插入;
- 链表长度达到 8:treeifyBin(table 长度不足 64 时优先扩容,超过 64 才真正树化);
- 最后
addCount累加元素数并判断是否需要扩容。
final V putVal(K key, V value, boolean onlyIfAbsent) {
    if (key == null || value == null) throw new NullPointerException();
    int hash = spread(key.hashCode());   // 综合高低位, hash 性更好且保证为正
    int binCount = 0;
    for (Node<K,V>[] tab = table;;) {
        Node<K,V> f; int n, i, fh;
        // 1) table 还没建: CAS 初始化, 下一轮重试
        if (tab == null || (n = tab.length) == 0)
            tab = initTable();
        // 2) 目标桶为空: CAS 新建头节点, 无锁
        else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
            if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null)))
                break;
        }
        // 3) 桶头是 MOVED: 正在扩容, 先帮忙迁桶
        else if ((fh = f.hash) == MOVED)
            tab = helpTransfer(tab, f);
        else {
            V oldVal = null;
            // 4) 锁住链表(树)头节点
            synchronized (f) {
                // double check: 锁内再次确认桶头没被换过
                if (tabAt(tab, i) == f) {
                    if (fh >= 0) {
                        binCount = 1;
                        for (Node<K,V> e = f;; ++binCount) {
                            K ek;
                            // 相同 key: 更新
                            if (e.hash == hash &&
                                ((ek = e.key) == key ||
                                 (ek != null && key.equals(ek)))) {
                                oldVal = e.val;
                                if (!onlyIfAbsent)
                                    e.val = value;
                                break;
                            }
                            Node<K,V> pred = e;
                            // 走到表尾: 新 Node 尾插
                            if ((e = e.next) == null) {
                                pred.next = new Node<K,V>(hash, key, value, null);
                                break;
                            }
                        }
                    }
                    // 红黑树 bin
                    else if (f instanceof TreeBin) {
                        Node<K,V> p;
                        binCount = 2;
                        if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) {
                            oldVal = p.val;
                            if (!onlyIfAbsent)
                                p.val = value;
                        }
                    }
                }
            } // 释放桶头锁

            if (binCount != 0) {
                // 链表长度 >= 8: 树化(内部会先看 table 是否达到 64)
                if (binCount >= TREEIFY_THRESHOLD)
                    treeifyBin(tab, i);
                if (oldVal != null)
                    return oldVal;
                break;
            }
        }
    }
    addCount(1L, binCount);   // 计数 +1, 并检查扩容
    return null;
}
initTable 用 sizeCtl 做开关:某个线程 CAS 把 sizeCtl 改成 -1 即获得初始化权,其它线程在循环里 yield 等待数组可见:
private final Node<K,V>[] initTable() {
    Node<K,V>[] tab; int sc;
    while ((tab = table) == null || tab.length == 0) {
        if ((sc = sizeCtl) < 0)
            Thread.yield();                      // 已有线程在初始化
        else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) {
            try {
                if ((tab = table) == null || tab.length == 0) {
                    int n = (sc > 0) ? sc : DEFAULT_CAPACITY;
                    Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n];
                    table = tab = nt;
                    sc = n - (n >>> 2);          // 阈值 = 0.75n
                }
            } finally {
                sizeCtl = sc;
            }
            break;
        }
    }
    return tab;
}
size 计算:baseCount + CounterCell 分桶计数
ConcurrentHashMap 的元素个数不是一个单独的整数,否则所有线程都去 CAS 同一个计数位会激烈竞争。它借鉴了 LongAdder 的思想:
- 没有竞争时,计数累加到
baseCount; - 一旦 CAS 失败(有竞争),就创建
CounterCell[],每个线程按探针值落到一个 cell 上累加,竞争越激烈 cell 可以越多; size()时把 baseCount 与所有 cell 的值相加。
private final void addCount(long x, int check) {
    CounterCell[] as; long b, s;
    if (
        // 已有 counterCells: 向 cell 累加
        (as = counterCells) != null ||
        // 否则先尝试累加到 baseCount
        !U.compareAndSwapLong(this, BASECOUNT, b = baseCount, s = b + x)
    ) {
        CounterCell a; long v; int m;
        boolean uncontended = true;
        if (as == null || (m = as.length - 1) < 0 ||
            (a = as[ThreadLocalRandom.getProbe() & m]) == null ||
            // cell 上 CAS 也失败: 进入 fullAddCount 建数组/建新 cell/重试
            !(uncontended = U.compareAndSwapLong(a, CELLVALUE, v = a.value, v + x))) {
            fullAddCount(x, uncontended);
            return;
        }
        if (check <= 1)
            return;
        s = sumCount();
    }
    if (check >= 0) {
        // s >= 阈值时进入扩容逻辑(见下)
        // ...
    }
}

public int size() {
    long n = sumCount();
    return ((n < 0L) ? 0 :
            (n > (long)Integer.MAX_VALUE) ? Integer.MAX_VALUE : (int)n);
}

final long sumCount() {
    CounterCell[] as = counterCells; CounterCell a;
    long sum = baseCount;
    if (as != null) {
        for (int i = 0; i < as.length; ++i) {
            if ((a = as[i]) != null)
                sum += a.value;
        }
    }
    return sum;
}
transfer:以 bin 为单位迁移,多线程协助扩容
扩容是 JDK 8 CHM 最精巧的部分,要点:
- 双倍容量 + 高低位拆分:容量翻倍后,一个旧桶里的元素按 hash 新增的那一位是 0 还是 1,拆成低位链(留在原下标)和高位链(迁到
旧下标 + 旧容量),因此平均只有约 1/6 的节点需要新建对象,其余节点引用直接复用。 - 以 bin 为单位加锁:迁移某个桶时 synchronized 锁桶头,锁的粒度只是一个桶,不同桶可以并行迁移。
- ForwardingNode 转发:一个桶迁移完毕,把旧 table 的该桶头替换为 ForwardingNode(hash=MOVED),其他线程来 put 时看见 MOVED 就去
helpTransfer帮忙,来 get 时则被转发到 nextTable 查询,扩容期间读写都不阻塞。 - 迁移任务的领取:
transferIndex像一个游标,每个线程 CAS 领取一段连续的桶(最小步长 16),迁完再领;sizeCtl 在扩容期间为-(1 + 扩容线程数),每加入一个协助线程 CAS 加 1,线程退出减 1,最后一个退出的线程负责把 nextTable 公布为正式 table 并把 sizeCtl 改为新阈值。
put 路径中触发/协助扩容的判断就在 addCount:
while (s >= (long)(sc = sizeCtl) && (tab = table) != null &&
       (n = tab.length) < MAXIMUM_CAPACITY) {
    int rs = resizeStamp(n);
    if (sc < 0) {
        // 扩容已在进行: 状态不匹配或任务已领完则退出
        if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc == rs + 1 ||
            sc == rs + MAX_RESIZERS || (nt = nextTable) == null ||
            transferIndex <= 0)
            break;
        // CAS 给扩容线程数 +1, 然后帮忙迁移
        if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1))
            transfer(tab, nt);
    }
    // 还没扩容: CAS 设置初始标记 (rs << 16) + 2, 并创建 nextTable
    else if (U.compareAndSwapInt(this, SIZECTL, sc,
                                 (rs << RESIZE_STAMP_SHIFT) + 2))
        transfer(tab, null);
    s = sumCount();
}
get 流程:全程无锁
get 不加锁,依赖 tabAt 的 volatile 读保证可见性:扩容前读到旧表就从旧表取,扩容后桶头是 ForwardingNode,它的 find 会转到新表继续找;红黑树则走 TreeBin 的 find:
public V get(Object key) {
    Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek;
    int h = spread(key.hashCode());   // 保证为正数
    if ((tab = table) != null && (n = tab.length) > 0 &&
        (e = tabAt(tab, (n - 1) & h)) != null) {
        // 头节点命中
        if ((eh = e.hash) == h) {
            if ((ek = e.key) == key || (ek != null && key.equals(ek)))
                return e.val;
        }
        // hash 为负: 正在扩容的 ForwardingNode 或 TreeBin, 交给 find 处理
        else if (eh < 0)
            return (p = e.find(h, key)) != null ? p.val : null;
        // 普通链表: 顺着 next 用 equals 比较
        while ((e = e.next) != null) {
            if (e.hash == h &&
                ((ek = e.key) == key || (ek != null && key.equals(ek))))
                return e.val;
        }
    }
    return null;
}
对比:JDK 7 ConcurrentHashMap(Segment 分段锁)
JDK 7 的思路是分段锁:维护一个 Segment[],每个 Segment 本身就是一把锁(继承自 ReentrantLock),内部再放一个 HashEntry 数组。多个线程访问不同 Segment 时互不影响——思想与 JDK 8 锁桶类似,但粒度粗得多。
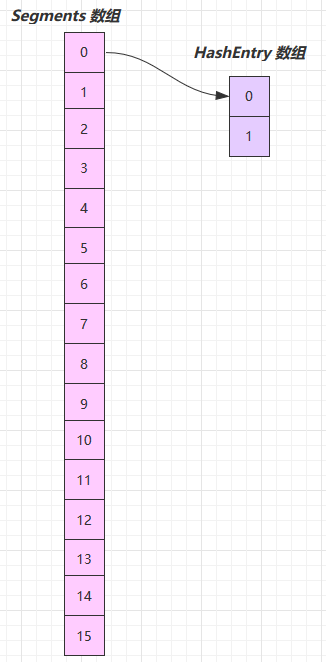
- 优点:多个线程访问不同 Segment 时没有冲突;
- 缺点:Segments 数组默认大小 16,初始化指定后不能改变,并且不是彻底的懒惰初始化(构造时就建好 segments[0] 并确定全部结构),空间占用不友好。
构造器中 segmentShift 默认 28、segmentMask 默认 15,定位时取 hash 高 4 位决定落在哪个 Segment:
int sshift = 0;
int ssize = 1;
while (ssize < concurrencyLevel) {   // ssize 必须是 2^n
    ++sshift;
    ssize <<= 1;
}
this.segmentShift = 32 - sshift;    // 默认 28
this.segmentMask = ssize - 1;       // 默认 15
// ...
Segment<K,V> s0 = new Segment<K,V>(loadFactor, (int)(cap * loadFactor),
                     (HashEntry<K,V>[])new HashEntry[cap]);
Segment<K,V>[] ss = (Segment<K,V>[])new Segment[ssize];
UNSAFE.putOrderedObject(ss, SBASE, s0);   // 只预先创建 segments[0]
put 先按高位定位 Segment(为空时用 CAS 保证只建一次),再进入段内,段本身就是 ReentrantLock:
final V put(K key, int hash, V value, boolean onlyIfAbsent) {
    // 先 tryLock; 失败进入 scanAndLockForPut:
    // 多核下最多自旋 tryLock 64 次, 还不行再 lock, 等待期间可顺便把新节点创建好
    HashEntry<K,V> node = tryLock() ? null :
        scanAndLockForPut(key, hash, value);
    V oldValue;
    try {
        HashEntry<K,V>[] tab = table;
        int index = (tab.length - 1) & hash;
        HashEntry<K,V> first = entryAt(tab, index);
        for (HashEntry<K,V> e = first;;) {
            if (e != null) {
                K k;
                if ((k = e.key) == key || (e.hash == hash && key.equals(k))) {
                    oldValue = e.value;
                    if (!onlyIfAbsent) {
                        e.value = value;
                        ++modCount;
                    }
                    break;
                }
                e = e.next;
            } else {
                // 新增: 头插法; 超阈值则在持锁状态下 rehash
                if (node != null)
                    node.setNext(first);
                else
                    node = new HashEntry<K,V>(hash, key, value, first);
                int c = count + 1;
                if (c > threshold && tab.length < MAXIMUM_CAPACITY)
                    rehash(node);
                else
                    setEntryAt(tab, index, node);
                ++modCount;
                count = c;
                oldValue = null;
                break;
            }
        }
    } finally {
        unlock();
    }
    return oldValue;
}
段内 rehash 已经持有锁,无需考虑线程安全,且有一个小优化:先过一遍链表找到 lastRun——尾段中迁移后下标不变的连续节点可以整段重用,只对前面的节点新建:
private void rehash(HashEntry<K,V> node) {
    HashEntry<K,V>[] oldTable = table;
    int oldCapacity = oldTable.length;
    int newCapacity = oldCapacity << 1;
    threshold = (int)(newCapacity * loadFactor);
    HashEntry<K,V>[] newTable =
        (HashEntry<K,V>[]) new HashEntry[newCapacity];
    int sizeMask = newCapacity - 1;
    for (int i = 0; i < oldCapacity; i++) {
        HashEntry<K,V> e = oldTable[i];
        if (e != null) {
            HashEntry<K,V> next = e.next;
            int idx = e.hash & sizeMask;
            if (next == null)
                newTable[idx] = e;
            else {
                HashEntry<K,V> lastRun = e;
                int lastIdx = idx;
                // 找到最后一个"下标发生变化"的节点, 其后的整段链表直接复用
                for (HashEntry<K,V> last = next; last != null; last = last.next) {
                    int k = last.hash & sizeMask;
                    if (k != lastIdx) {
                        lastIdx = k;
                        lastRun = last;
                    }
                }
                newTable[lastIdx] = lastRun;
                // 前面的节点需要新建
                for (HashEntry<K,V> p = e; p != lastRun; p = p.next) {
                    V v = p.value;
                    int h = p.hash;
                    int k = h & sizeMask;
                    HashEntry<K,V> n = newTable[k];
                    newTable[k] = new HashEntry<K,V>(h, p.key, v, n);
                }
            }
        }
    }
    // 扩容完成后才加入触发扩容的新节点
    int nodeIndex = node.hash & sizeMask;
    node.setNext(newTable[nodeIndex]);
    newTable[nodeIndex] = node;
    table = newTable;
}
JDK 7 的 get 同样不加锁,用 getObjectVolatile 保证读到最新引用;它的 size 统计则是另一种策略:先无锁计算两次,各段的 modCount 之和与上次一致就认为准确;不一致则重试,重试超过 3 次(RETRIES_BEFORE_LOCK)就把所有 Segment 锁住重新统计。JDK 8 用 CounterCell 分桶计数彻底替代了这种"要么不准要么全锁"的方式。
LinkedBlockingQueue 原理
基本的入队出队
LinkedBlockingQueue 是基于链表的有界阻塞队列,结构上有两个关键设计:一个 Dummy(哑元)节点和两把锁。节点的 next 指针有三种含义:真正的后继节点、指向自己(出队时 help GC)、null(队尾):
static class Node<E> {
    E item;

    /**
     * 下列三种情况之一:
     * - 真正的后继节点
     * - 自己, 发生在出队时
     * - null, 表示没有后继, 是最后了
     */
    Node<E> next;

    Node(E x) { item = x; }
}
初始化时 last = head = new Node<E>(null),Dummy 节点 item 为 null 用来占位。第一个节点入队,执行 last = last.next = node:
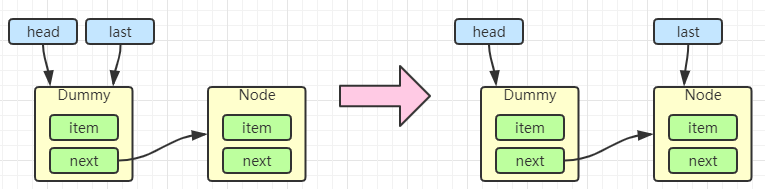
再来一个节点入队,last 继续后移:
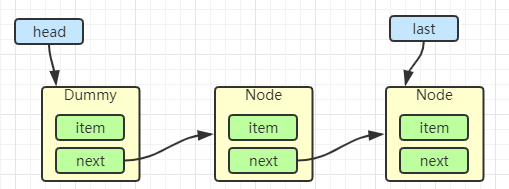
出队时不直接移动 Dummy,而是把 Dummy 的后继(第一个真实节点)摘下、把它变成新的 Dummy:
Node<E> h = head;
Node<E> first = h.next;   // 第一个真实节点
h.next = h;               // 旧 Dummy 自引用, help GC
head = first;
E x = first.item;
first.item = null;        // 新 head 清空 item, 成为新的 Dummy
return x;
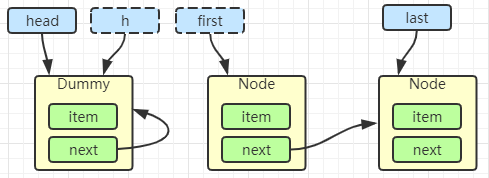
first = h.next 后:
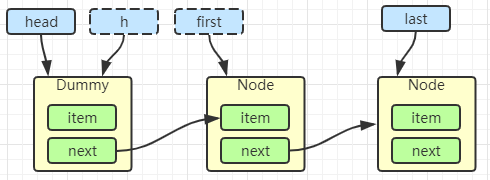
执行 h.next = h,旧 Dummy 自己指自己,与链表断开:
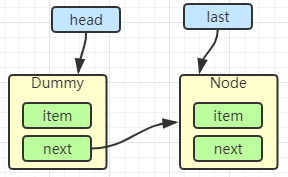
head = first 且 first.item = null 后,出队完成——曾经的第一个真实节点变成了新的 Dummy:
加锁分析:两把锁 + Dummy 节点
高明之处在于用了两把锁:
// 用于 put(阻塞) / offer(非阻塞), 保护 last
private final ReentrantLock putLock = new ReentrantLock();

// 用于 take(阻塞) / poll(非阻塞), 保护 head
private final ReentrantLock takeLock = new ReentrantLock();- 用一把锁:同一时刻最多只允许一个线程执行(生产者、消费者二选一);
- 用两把锁:同一时刻可以有一个生产者和一个消费者并行执行;
- 消费者与消费者之间仍串行,生产者与生产者之间仍串行。
线程安全分析:
- 节点总数大于 2(含 Dummy)时,putLock 保证 last 端安全、takeLock 保证 head 端安全,入队出队操作的不是同一个节点,没有竞争;
- 节点总数等于 2(一个 Dummy + 一个真实节点)时,仍是两把不同的锁锁两个对象,不会竞争;
- 节点总数等于 1(只剩 Dummy)时,take 线程会在 notEmpty 条件上阻塞;反之队列满时 put 线程在 notFull 条件上阻塞。
两把锁配两个 Condition:notEmpty 由 takeLock 管理、notFull 由 putLock 管理;元素个数用 AtomicInteger count 维护,让两端都能读计数而不必持有对方的锁。
put 操作
public void put(E e) throws InterruptedException {
    if (e == null) throw new NullPointerException();
    int c = -1;
    Node<E> node = new Node<E>(e);
    final ReentrantLock putLock = this.putLock;
    final AtomicInteger count = this.count;
    putLock.lockInterruptibly();
    try {
        // 队列满了: 在 notFull 上等待
        while (count.get() == capacity) {
            notFull.await();
        }
        enqueue(node);
        c = count.getAndIncrement();
        // 入队后还有空位: 自己顺手叫醒其它等待的 put 线程
        if (c + 1 < capacity)
            notFull.signal();
    } finally {
        putLock.unlock();
    }
    // 入队前队列是空的(c==0): 可能有 take 线程在睡, 叫醒一个
    // 用 signal 而不是 signalAll, 减少无效竞争
    if (c == 0)
        signalNotEmpty();
}
两个唤醒细节值得注意:
c == 0才调用signalNotEmpty():只有"从空到非空"这一下,消费者才可能正在等待,其余时候 take 线程会自己接力唤醒(见 take 中的c > 1);c + 1 < capacity时生产者自己唤醒其他生产者,原因见后文。
take 操作
public E take() throws InterruptedException {
    E x;
    int c = -1;
    final AtomicInteger count = this.count;
    final ReentrantLock takeLock = this.takeLock;
    takeLock.lockInterruptibly();
    try {
        // 队列空: 在 notEmpty 上等待
        while (count.get() == 0) {
            notEmpty.await();
        }
        x = dequeue();
        c = count.getAndDecrement();
        // 出队前至少有 2 个元素: 还有货, 叫醒其它 take 线程
        if (c > 1)
            notEmpty.signal();
    } finally {
        takeLock.unlock();
    }
    // 出队前队列是满的(c==capacity): 可能有 put 线程在等空位, 叫醒一个
    // 多个线程出队时只有第一个满足 c==capacity, 后续线程 c<capacity
    if (c == capacity)
        signalNotFull();
    return x;
}
为什么要"由 put 唤醒 put"
这是初读源码最容易疑惑的点:notFull 的唤醒者一般是 take 线程,但 take 只在 c == capacity(队列从满变非满的那一下)才 signal 一次。考虑这个场景:
- 队列已满,put2、put3 等多个生产者在
notFull.await()上排队; - 一个消费者 take 走一个元素,计数从 capacity 变为 capacity-1,signal 一次 notFull,只够叫醒 put2;
- put2 醒来入队,此时计数又回到 capacity——但注意,put2 入队之前计数是 capacity-1,队列里其实还空着一个位置(它占的就是这个空位),它入队后虽然满了,可在它入队的过程中完全可能又有消费者取走了元素,并且那个消费者看到的是"出队前不满"(c < capacity),按规则不会发 notFull 信号;
- 如果 put2 入队后不做点什么,put3 就可能再也等不到信号而永久沉睡——这就是信号不足。
所以 put 在发现 c + 1 < capacity(自己入队后仍有空位)时,由自己再 signal 一次 notFull,把唤醒接力传下去。take 侧的 c > 1 同理:消费者之间也要互相叫醒,保证 notEmpty 信号不断流。signal 只唤醒一个、配合 while 防虚假唤醒,既不漏信号也不造成惊群。
offer 及与 ArrayBlockingQueue 的比较
offer 是 put 的非阻塞版本:拿到 putLock 后如果队列已满,直接返回 false,不入队等待;带超时的 offer(e, timeout, unit) 则用 notFull.awaitNanos 限时等待。poll 与 take 的关系与此对称。
LinkedBlockingQueue 与 ArrayBlockingQueue 的对比:
- Linked 支持可选有界(默认
Integer.MAX_VALUE),Array 强制有界; - Linked 底层是链表,Array 底层是数组;
- Linked 是懒惰的(入队才 new Node),Array 需要提前初始化整个对象数组;
- Linked 每次入队生成新 Node,Array 的槽位对象提前创建、循环复用;
- Linked 用两把锁(入队/出队并行),Array 只用一把锁,这是二者并发度差异的根源。
小结
- JDK 7 HashMap 的
transfer采用头插法,两个线程一个迁完、一个迁到一半时,暂停线程栈中的 e/next 与新链表互相作用,会构造出节点互指的环形链表;JDK 8 改尾插 + 高低位拆分消除了死链,但并发场景仍必须用 ConcurrentHashMap。 - JDK 8 ConcurrentHashMap:懒惰初始化、sizeCtl 一个变量表达多种状态;空桶 CAS 放头、非空桶 synchronized 锁桶头;size 用 baseCount + CounterCell 分桶计数;扩容以桶为单位、ForwardingNode 转发读写、多线程可以协助迁移;get 全程无锁。
- JDK 7 ConcurrentHashMap 用 Segment 分段锁,段数组固定且初始化不彻底,size 要么无锁重试、要么全段加锁,是理解 JDK 8 锁桶设计的对照样本。
- LinkedBlockingQueue 靠 Dummy 节点 + putLock/takeLock 两把锁让生产者和消费者真正并行;唤醒信号只在空/满边界由对方发出,靠"同类唤醒同类"接力传递,避免等待线程因信号不足永久沉睡。